SIMD
SIMD意为单指令多数据(Single Instruction, Multiple Data),是一种并行计算的方式,允许在单个指令周期内同时处理多个数据元素。
一种常见的SIMD指令集是SSE(Streaming SIMD Extensions),它提供了一组指令,可以同时处理多个数据元素,例如同时对四个浮点数进行加法运算。
#include <x86intrin.h>

int main()
{
    int a[4] = {1, 2, 3, 4};
    int b[4] = {5, 6, 7, 8};
    __m128i va = _mm_loadu_si128((__m128i*)a); // 加载数组a到SIMD寄存器
    __m128i vb = _mm_loadu_si128((__m128i*)b); // 加载数组b到SIMD寄存器
    __m128i vc = _mm_add_epi32(va, vb); // 同时对四个整数进行加法运算
    int c[4];
    _mm_storeu_si128((__m128i*)c, vc); // 将结果存储回数组c
}
SSE指令集是一种较早的SIMD指令集,后来又有了AVX(Advanced Vector Extensions)等更先进的指令集,支持一次计算512,256,128等等的数据。
多线程
概念
线程就是一串指令。一个进程可以分成多个线程,每个线程可以独立执行不同的指令。
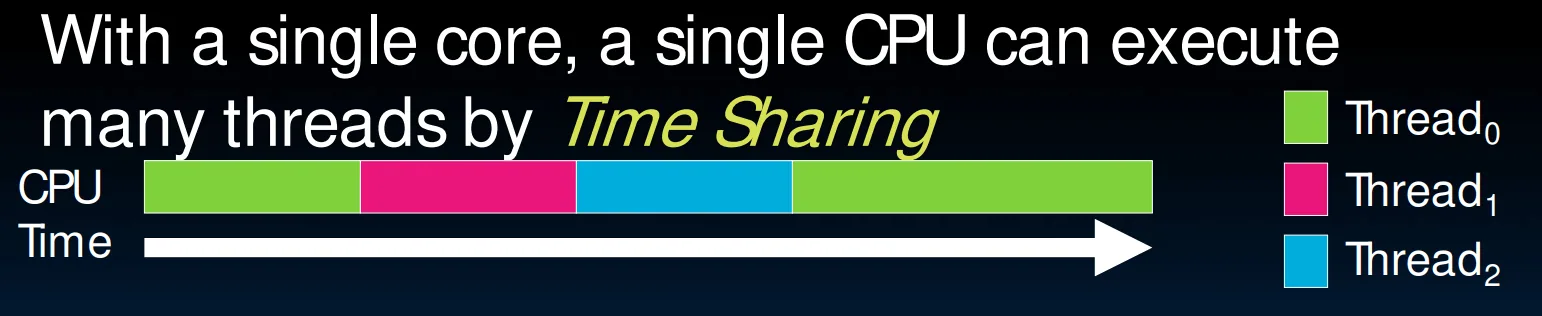
CPU通过时间片轮转的方式在不同的线程之间切换,使得多个线程看起来像是同时执行的。
- 硬件线程: 现代CPU通常支持多个硬件线程,例如超线程技术允许每个物理核心同时处理两个线程。
- 软件线程: 进程可以创建多个软件线程,这些线程由操作系统调度器管理,分配CPU时间片。
OpenMP
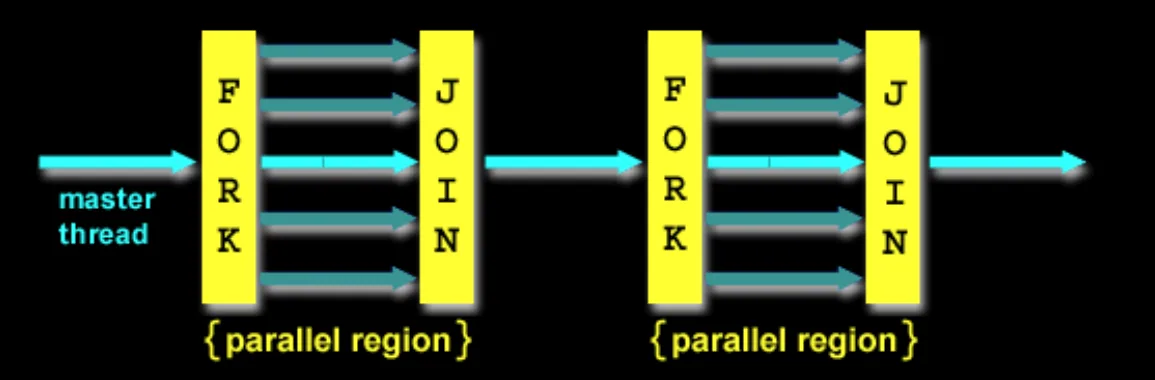
OpenMP提供了一种简单的方式来实现多线程编程,使用编译器指令来指定哪些代码块应该并行执行。
#include <omp.h>
#include <stdio.h>
int main()
{
    omp_set_num_threads(4); // 设置线程数量
    int a[] = {1, 2, 3, 4, 5, 6, 7, 8};
    int N = sizeof(a) / sizeof(a[0]);

    #pragma omp parallel for // 指示编译器并行执行下面的for循环
    for (int i = 0; i < N; i++)
    {
        a[i] = a[i] * 2; // 每个线程处理数组的一部分
    }

    #pragma omp parallel for
    for (int i = 0; i < N; i++)
    {
        printf("%d ", a[i]); // 输出结果,应该为乱序
    }
}
锁
当多个线程需要访问共享资源时,可能会发生竞争条件。
为了避免这种情况,可以使用锁(lock)来保护共享资源,确保同一时间只有一个线程可以访问它。
        li t0, 1                            # Get 1 to set lock
Try:    amoswap.w.aq t1, t0, (a0)           # t1 gets old lock value
                                            # while we set it to 1
        bnez t1, Try                        # if it was already 1, another
                                            # thread has the lock,
                                            # so we need to try again
        … critical section goes here …
amoswap.w.rl x0, x0, (a0) # store 0 in lock to release对OpenMP来说,编译器会自动为我们处理锁的细节,我们只需要使用#pragma omp critical来指定临界区即可。
#pragma omp critical
{
    sum += a[i];
    // 只有一个线程可以执行这里的代码
}
缓存共享
当多个CPU核心运行时,他们的L1,L2的独立缓存可能会导致数据不一致的问题。
SMP(Symmetric Multiprocessing)系统通过缓存一致性协议(Cache Coherence Protocol)来解决这个问题,确保所有核心看到的内存数据是一致的。
| 状态 | 核心含义 | 数据是否最新 | 其他缓存是否有副本 | 是否允许直接写 | 内存数据是否最新 |
|---|---|---|---|---|---|
| Shared | 共享,只读 | 是 | 可能有 | 否 | 不确定(可能过期) |
| Modified | 修改(脏),独占 | 是 | 无 | 是 | 过期(需写回) |
| Exclusive | 独占,干净 | 是 | 无 | 是 | 最新 |
| Owner | 拥有者,可脏共享 | 是 | 可能有(必须为 Shared) | 是(需广播更改) | 可能过期 |
| Invalid | 无效 | 否 | 不适用 | 否 | 无关 |
下面是一个简单的示例:
假设:地址 X 初始值为 5,内存最新,两个核心的缓存行初始均为 Invalid (I)。
- 独占读取(Exclusive):Core 1 执行 load X,缓存未命中,从内存读入数据并确认没有其他核心持有副本,该缓存行状态直接设为 Exclusive (E),表示数据干净且独占。
- 共享读取(Shared):随后 Core 2 也执行 load X,Core 1 监听到该请求,将自己 E 状态的副本降级为 Shared (S) 并将数据共享给 Core 2,Core 2 同样以 Shared (S) 状态获得数据。此时两个核心均为 S,内存仍是最新。
- 写入后形成脏共享(Modified → Owner):
- Core 1 首先执行 store X, 10:由于当前是 S 状态没有写入权限
- Core 1 向总线发出失效请求使 Core 2 的 S 副本变为 Invalid (I),自己升级为 Modified (M) 并写入 10,内存过时。
- 紧接着 Core 2 再次执行 load X:缺失后由 Core 1 的 M 副本直接提供脏数据,Core 1 转变为 Owner (O),Core 2 变为 Shared (S)。
- 此时脏数据在缓存间共享,内存仍过时。
- Owner 的后续动作:Core 1 作为 Owner 可以选择继续写入或写回内存。
- 若再次执行 store X, 20,它会先广播失效 Core 2 的 S 副本使其失效,自己从 O 变回 M 并更新数据;
- 若主动将脏数据写回内存,则自身降级为 S,Core 2 保持 S,内存变为最新。
MapReduce
MapReduce是一种分布式计算框架,允许在大规模数据集上进行并行处理。
例子:计算一个大文本文件(TB,PB级别,而且可能分布在不同的节点)中每个单词出现的次数。
- 输入分片: 将大文本文件分成多个小块,每个块可以在不同的节点上处理。
- Map阶段: 每个节点执行一个Map函数,读取分片中的文本。例如对于分片中的文本 “hello world hello”,Map函数会输出一个键值对列表:[(hello, 1), (world, 1), (hello, 1)]。
- Shuffle阶段: MapReduce框架会将所有Map输出的键值对进行分组,将相同键的值聚集在一起。例如,所有关于 “hello” 的键值对会被发送到同一个节点。
- Reduce阶段: 每个节点执行一个Reduce函数,处理分组后的键值对。例如,对于 “hello” 的键值对列表 [(hello, 1), (hello, 1)],Reduce函数会将它们合并成一个键值对 (hello, 2),表示 “hello” 出现了两次。
SPARK:
SPARK是一个基于内存的分布式计算框架,提供了比MapReduce更高效的计算模型。
下面是一个使用SPARK实现单词计数的示例:
from pyspark import SparkContext
sc = SparkContext("local", "Word Count") # 创建一个SparkContext对象
text_file = sc.textFile("hdfs://path/to/large_text_file.txt") # 读取大文本文件

"""
1. flatMap: 将每行文本分割成单词,输出一个包含所有单词的列表
2. map: 将每个单词映射为一个键值对 (word, 1),表示该单词出现了一次
3. reduceByKey: 对相同键的值进行聚合,将每个单词的出现次数相加
"""
counts = text_file.flatMap(lambda line: line.split(" ")) \
             .map(lambda word: (word, 1)) \
             .reduceByKey(lambda a, b: a + b)

counts.saveAsTextFile("hdfs://path/to/output") # 将结果保存到HDFS