总体结构
磁盘
在硬件上磁盘分为若干个扇区,操作系统将多个扇区组合成一个块读写
具体对于virtio磁盘,1个扇区是512字节;对XV6,1个块是1024字节,即2个扇区,即BSIZE = 1024
下面是磁盘的布局
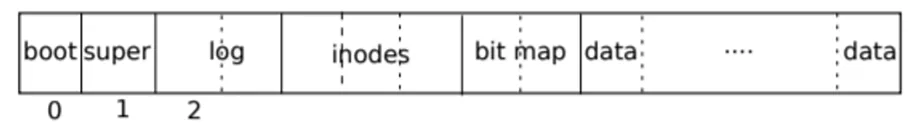
| 块号 | 区域 | 块数 | 用途 |
|---|---|---|---|
| 0 | boot block | 1 | 引导块加载内核 |
| 1 | super block | 1 | 超级块描述磁盘布局 |
| 2 ~ 32 | log | 31 | 日志区负责崩溃恢复 |
| 33 ~ 45 | inode blocks | 13 | 存 dinode |
| 46 | bitmap | 1 | 位图,1 位/块 |
| 47 ~ 1999 | data blocks | 1953 | 文件与目录内容 |
引导块通常存有引导程序,负责启动时将系统内核加载到内核中运行。在XV6中QEMU直接将内核开始处拷贝到内存中的固定位置,所以引导块并没有实际用上
超级块记录了磁盘的布局信息,其具体成员定义如下
struct superblock {
  uint magic;      // Must be FSMAGIC
  uint size;       // Size of file system image (blocks)
  uint nblocks;    // Number of data blocks
  uint ninodes;    // Number of inodes.
  uint nlog;       // Number of log blocks
  uint logstart;   // Block number of first log block
  uint inodestart; // Block number of first inode block
  uint bmapstart;  // Block number of first free map block
};inode区存放dinode,是描述文件的核心结构体。bitmap区是位图,记录了磁盘上哪些块已经被使用,哪些块是空闲的,每一块用一位表示。data blocks区存放文件的具体数据
分层
XV6设计的文件系统分为若干层次,从上到下依次为
- File Descriptor: 文件描述符层,抽象Unix资源供程序使用
- Pathname: 路径名层,提供层次的路径名
- Directory: 目录层,目录被视作一个文件,记录了名字-
inode的映射关系 - Inode:
inode层,文件的内容管理,通过此找到磁盘具体数据 - Logging: 日志层,将操作打包为事务,保存崩溃也能一致
- Buffer Cache: 缓冲层,缓存磁盘数据,减少磁盘I/O,提供锁做同步
- Disk: 磁盘层,提供对磁盘的读写操作
调用链
学习这一章容易陷入函数的海洋中,这一章函数极其多,很容易看懂代码但是搞不清函数在哪里调用,什么时候调用
下面将读文件,写文件,创造文件,删除文件的全过程调用链总结出来,此节可以暂时先跳过,读完下面函数之后再回来看
总则
- 所有对磁盘的读,最终收敛到缓冲层的
bread,用完brelse释放缓冲区 - 所有对磁盘的写都不直接写。先是
bread拿到原始数据,在内核缓冲区进行修改(修改的是内存,磁盘没有改),然后调用log_write登记事务,brelse释放缓冲区,最后由日志层的end_op决定commit之后调用缓冲层的bwrite写回磁盘
读文件
read(fd, buf, n)                                [用户]
└─ sys_read                                     [系统调用层] 取参、argfd 找 struct file
   └─ fileread(f, addr, n)                      [文件描述符层] 按 f->type 分发,走 FD_INODE 分支
      ├─ ilock(f->ip)                           [inode 层] 上睡眠锁,valid==0 时读 dinode
      ├─ readi(ip, 1, addr, f->off, n)          [inode 层] 按字节偏移逐块读
      │  └─ 循环每块
      │     ├─ bmap(ip, off/BSIZE)              [inode 层] 文件块号 -> 磁盘块号(读路径不分配)
      │     ├─ bread(ip->dev, addr)             [缓冲层] 命中直接用,miss 才 virtio_disk_rw 读盘
      │     ├─ either_copyout(...)              块内容 -> 用户地址
      │     └─ brelse(bp)                       [缓冲层] 放回 LRU
      ├─ iunlock(f->ip)                         [inode 层]
└─ f->off += r [文件描述符层] 偏移在这里更新,不在 inode 层用户态程序通过read系统调用,到内核中就是sys_read,sysread调用fileread,对于普通文件而言,经过inode层的ilock获取inode.lock睡眠锁之后,调用readi读取文件内容。readi通过bmap找到文件对应数据块之后,调用缓冲层函数bread,之后用either_copyout将数据拷贝到用户空间,最后调用brelse释放缓冲区。最后iunlock释放inode层睡眠锁
注意读文件不需要日志,需要inode的睡眠锁
写文件
write(fd, buf, n)
└─ sys_write                                    [系统调用层]
   └─ filewrite(f, addr, n)                     [文件描述符层]
      └─ 循环分批(每批 <= max)
         ├─ begin_op()                          [日志层] 进入事务
         ├─ ilock(f->ip)                        [inode 层]
         ├─ writei(ip, 1, src, off, n1)         [inode 层] 逐块写
         │  ├─ 循环每块
         │  │  ├─ bmap(ip, off/BSIZE)           [inode 层] 块不存在 -> balloc
         │  │  │  └─ balloc                     [inode 层] bread 位图 -> 置位 -> bzero
         │  │  │     └─ log_write(位图块)       [日志层]
         │  │  ├─ bread(ip->dev, addr)          [缓冲层]
         │  │  ├─ either_copyin(...)            用户数据 -> 块内容
         │  │  ├─ log_write(bp)                 [日志层] 登记数据块
         │  │  └─ brelse(bp)                    [缓冲层]
         │  └─ ip->size=off; iupdate(ip)        [inode 层] 登记 inode 块
         ├─ iunlock(f->ip)                      [inode 层]
         └─ end_op()                            [日志层] 最后一个 outstanding 触发 commit
            └─ commit()                         [日志层]
               ├─ write_log()                   缓存 -> 日志区
               ├─ write_head()                  真正提交点
               ├─ install_trans()               日志区 -> 实际块号
└─ write_head() 清空日志写文件更为复杂一些,普通文件的写系统调用最终到达filewrite函数。先调用begin_op进入事务,之后调用ilock获取inode.lock睡眠锁,随后调用writei写入文件内容。writei通过bmap找到文件对应数据块。用bread读到磁盘数据之后,用either_copyin将用户数据拷贝到缓冲区,之后调用log_write登记事务,最后调用brelse释放缓冲区。全部完成之后iunlock释放inode.lock睡眠锁,最后调用end_op结束事务,触发日志提交
创造文件
open(path, O_CREATE) / mkdir(path) / mknod(path, ...)
└─ sys_open / sys_mkdir / sys_mknod             [系统调用层] 先 begin_op()
   ├─ create(path, type, major, minor)          [系统调用层, static]
   │  ├─ nameiparent(path, name)                [路径名层] 父目录 inode + 最后一段名字
   │  ├─ ilock(dp)                              [inode 层] 锁父目录,让"查重+分配+链接"原子
   │  ├─ dirlookup(dp, name, 0)                 [目录层] 先查有没有重名
   │  ├─ ialloc(dp->dev, type)                  [inode 层] 找空闲 dinode -> 标 type -> iget
   │  │  └─ log_write(dinode 块)                [日志层]
   │  ├─ ilock(ip)
   │  ├─ ip->nlink=1; iupdate(ip)               [inode 层]
   │  ├─ 若 type == T_DIR
   │  │  ├─ dirlink(ip, ".",  ip->inum)         [目录层]
   │  │  └─ dirlink(ip, "..", dp->inum)         [目录层]
   │  ├─ dirlink(dp, name, ip->inum)            [目录层] 写一条 dirent
   │  │  └─ writei(dp, ...)                     [inode 层] 目录也是文件
   │  │     └─ bmap / bread / log_write / brelse [inode 层 + 日志层 + 缓冲层]
   │  └─ iunlockput(dp)                         [inode 层]
   ├─ filealloc()                               [文件描述符层] 分配 struct file
   ├─ fdalloc(f)                                [系统调用层] 进程 ofile[] 找空 fd
   ├─ f->type=FD_INODE; f->off=0; f->ip=ip
   ├─ 若 O_TRUNC: itrunc(ip)                    [inode 层]
   ├─ iunlock(ip)                               [inode 层]
   └─ end_op()                                  [日志层]
删除文件
unlink(path)
└─ sys_unlink                                   [系统调用层] begin_op()
   ├─ nameiparent(path, name)                   [路径名层] 父目录 dp + 名字
   ├─ ilock(dp)                                 [inode 层]
   ├─ dirlookup(dp, name, &off)                 [目录层] 找到目标 ip + 目录项偏移 off
   ├─ ilock(ip)                                 [inode 层]
   ├─ 检查 nlink>=1;若目录还需 isdirempty
   ├─ writei(dp, 0, &空dirent, off, ...)        [inode 层] 把目录项清零(删"名字")
   ├─ 若是目录: dp->nlink--; iupdate(dp)        [inode 层]
   ├─ iunlockput(dp)                            [inode 层]
   ├─ ip->nlink--; iupdate(ip)                  [inode 层] 只把磁盘链接数 -1
   ├─ iunlockput(ip)                            [inode 层] -> iput,真正的释放在这里
   │  └─ iput: 若 ref==1 && valid && nlink==0
   │     ├─ itrunc(ip)                          [inode 层] bfree 直接块 + 间接块,size=0
   │     └─ ifree(dev, inum)                    [inode 层] 磁盘 dinode type=0
   └─ end_op()                                  [日志层]
缓冲区
| 分类 | 函数 | 作用 |
|---|---|---|
| 初始化 | binit | 将缓冲区初始化为双向链表 |
| 取块 | bget | 查缓存,未命中则分配新的,不读磁盘,会拿锁 |
| 读块 | bread | 调用 bget;数据无效真正读磁盘 |
| 写块 | bwrite | 把内容写回磁盘,只有日志层调用 |
| 释放 | brelse | 释放睡眠锁,释放缓冲块 |
所有对磁盘的读写最终都落到缓冲区层。bread不关心块的属性,它只从对应设备的对应块号取出内容,通过调用bget在缓冲区内分配。bwrite与bread类似,只不过读变成了写,只有日志层调用它,在事务结束生效之后正式写入。brelse释放缓冲块
缓冲区结构
缓冲层的核心是bcache,其内部有长度为NBUF的缓冲区数组buf[NBUF]
struct {
  struct spinlock lock;
  struct buf buf[NBUF];   // 30 块缓存

  // Linked list of all buffers, through prev/next.
  // Sorted by how recently the buffer was used.
  // head.next is most recent, head.prev is least.
  struct buf head;        // 哨兵节点,不存数据
} bcache;
struct buf {
int valid; // 内存副本是否有效
int disk; // 磁盘是否正占用它
uint dev; // 设备号
uint blockno; // 块号
struct sleeplock lock; // 睡眠锁,保护 data
uint refcnt; // 引用计数:多少人在用
struct buf *prev;
struct buf *next;
uchar data[BSIZE];// 块内容,BSIZE=1024
};每一个buf都有一个sleeplock,用于保护data。bcache也有一把大自旋锁保护整个缓冲区,拿到具体的buf的睡眠锁之前要放掉
启动时main调用binit()初始化缓冲区,其将缓冲区各个buf链接为带哨兵节点的双向循环链表
void
binit(void)
{
  struct buf *b;

  initlock(&bcache.lock, "bcache");

  // 哨兵节点先自己成环
  bcache.head.prev = &bcache.head;
  bcache.head.next = &bcache.head;
  // 遍历数组中的所有buf
  for (b = bcache.buf; b < bcache.buf + NBUF; b++) {
    // 将buf插入链表头部,也就是哨兵节点的下一位
    b->next = bcache.head.next;
    b->prev = &bcache.head;
    // 初始化睡眠锁
    initsleeplock(&b->lock, "buffer");
    bcache.head.next->prev = b;
    bcache.head.next = b;
  }
}链表被特意设计为LRU形式,即虽然已占用的buf和空闲的buf混在一起,但是对于空闲的buf而言,从链表哨兵头开始向后遍历,越靠前的空闲buf越是最近释放的。这个规则是由brelse()函数实现的。当释放一个buf就将其移至链表头部
bget
bget()尝试通过设备号和块号找到对应已有的buf,如果找不到就分配一个空闲的buf,然后填上设备号和块号。返回的buf已经拿到睡眠锁
static struct buf *
bget(uint dev, uint blockno)
{
  struct buf *b;

  acquire(&bcache.lock);            // 全程持锁

  // 判断是否已经被缓存过
  // 从链表头往后走
  for (b = bcache.head.next; b != &bcache.head; b = b->next) {
    if (b->dev == dev && b->blockno == blockno) {
      b->refcnt++;                  // 命中:引用 +1
      release(&bcache.lock);
      acquiresleep(&b->lock);       // 先释放大锁,再拿该buf的睡眠锁
      return b;
    }
  }

  // 找不到,没有被缓存
  // 从链表尾往前走,head.prev即为链表尾部
  for (b = bcache.head.prev; b != &bcache.head; b = b->prev) {
    if (b->refcnt == 0) {           // 找空闲块
      b->dev = dev;
      b->blockno = blockno;
      b->valid = 0;                 // 关键:迫使 bread 重新读盘
      b->refcnt = 1;
      release(&bcache.lock);
      acquiresleep(&b->lock);
      return b;
    }
  }
  panic("bget: no buffers");
}bget没有实际读磁盘数据,而是仅仅在缓存区中占位
找到过程中,必须先放掉大锁再拿睡眠锁,因为陷入睡眠时不可以持有别的锁。这样的实现是安全的,因为refcnt++保证了buf不会被释放掉
对于新占用的块清空valid,迫使后面的bread()函数重新从磁盘读取数据
锁的使用保证了一个磁盘块只会有最多一个buf与之对应
注意占用新缓存时从链表尾部开始向前读,体现了LRU原则。LRU的维护由brelse()保证
bread
bread尝试从缓冲区中取对应块,如果块内数据无效,就从磁盘读取数据到缓冲区中
struct buf *
bread(uint dev, uint blockno)
{
  struct buf *b;

  b = bget(dev, blockno);
  if (!b->valid) {
    virtio_disk_rw(b, 0);   // 0 = 读,真正和磁盘交互
    b->valid = 1;
  }
  return b;                  // 返回已加锁的 buf
}virtio_disk_rw是真正与磁盘交互的函数,他会睡眠以等待一次磁盘I/O完成
bwrite
// Write b's contents to disk.  Must be locked.
// Only the log calls bwrite.
void
bwrite(struct buf *b)
{
  if (!holdingsleep(&b->lock))
    panic("bwrite");
  virtio_disk_rw(b, 1);      // 1 = 写
}
只有日志层会调用这个函数,决定数据是否脏了需要写回
brelse
brelse释放一个buf,将其从链表中移到头部,保证LRU原则
void
brelse(struct buf *b)
{
  if (!holdingsleep(&b->lock))
    panic("brelse");

  releasesleep(&b->lock);       // 释放睡眠锁

  acquire(&bcache.lock);
  b->refcnt--;                  // 引用 -1
  if (b->refcnt == 0) {
    // no one is waiting for it.
    b->next->prev = b->prev;    // 从当前位置摘下
    b->prev->next = b->next;
    b->next = bcache.head.next; // 插到 head 后面(最近使用端)
    b->prev = &bcache.head;
    bcache.head.next->prev = b;
    bcache.head.next = b;
  }
  release(&bcache.lock);
}先放睡眠锁再拿大锁与前面保持对称,避免死锁。当refcnt为0时,说明没有人使用这个buf了,就将其从链表中摘下并插到链表头部
mkfs
mkfs不属于XV6系统,是跑在QEMU之外的主机程序,用于建立硬盘,在内核启动之前执行。下面是他的步骤
- 打开:创建
fs.img,把整块镜像清零 - 计算布局:根据
FSSIZE、NINODES、BSIZE算出日志块数、inode 块数、位图块数,进而得到logstart、inodestart、bmapstart和各区大小 - 写超级块到 1 号块
- 创建根目录:分配 1 号
inode(T_DIR),写入.和..两条目录项 - 写入各用户程序:为每个文件分配 inode 和数据块,内容拷进数据块,并在根目录追加一条目录项
- 写位图:把“已被占用的块”(元数据块 + 刚才分配的数据块)对应的位全部置 1,其余保持 0
结果是镜像里有了合法的超级块、根目录、用户程序,以及一张正确的位图。之后内核运行时,通过 balloc/bfree 在这张位图上继续分配和回收
块分配器
块分配器位于日志层之上,负责分配和回收磁盘块并管理位图
| 分类 | 函数/宏 | 作用 |
|---|---|---|
| 定位 | BBLOCK | 给定块号算它在哪个位图块 |
| 分配 | balloc | 从前往后扫位图找到0位置1占用,返回块号 |
| 释放 | bfree | 把对应位图位清 0 |
| 辅助 | bzero | 把指定块清零 |
块分配器所谓的分配与回收块本质上是修改位图中对应块的位,1表示占用,0表示空闲。balloc分配占用一个空闲的磁盘块,bfree释放一个已占用的磁盘块。bzero是辅助函数,清零一个块的内容,为了保证安全,balloc分配一个块之后会调用bzero清零该块内容,避免泄露之前的内容
位图
位图区中的每一位表示一个块的使用情况,1表示已被占用,0表示空闲,通常位图区第个位表示第个块的使用情况,线性映射。一个位图块能表示 BPB = BSIZE*8 = 8192 个块。具体映射方法定义了宏
#define BPB (BSIZE * 8)                          // 8192
#define BBLOCK(b, sb) ((b) / BPB + sb.bmapstart) // 块 b 的位在哪个位图块b是块的编号,sb是超级块,sb.bmapstart是位图块的起始块号。XV6中 bmapstart=46 且 FSSIZE=2000 < BPB,即一个位图块就能存下所有块的占用信息,所以所有块都在位图块 46
balloc
// Allocate a zeroed disk block.
// returns 0 if out of disk space.
static uint
balloc(uint dev)
{
  int b, bi, m;
  struct buf *bp;

  bp = 0;
  for (b = 0; b < sb.size; b += BPB) {              // 外层:逐个位图块
    bp = bread(dev, BBLOCK(b, sb));                 // 读入位图块(已加锁)
    for (bi = 0; bi < BPB && b + bi < sb.size; bi++) { // 内层:逐位
      m = 1 << (bi % 8);                            // 字节内掩码
      if ((bp->data[bi / 8] & m) == 0) {            // 该位为 0 => 空闲
        bp->data[bi / 8] |= m;                      // 置 1:标记占用
        log_write(bp);                              // 登记进事务
        brelse(bp);
        bzero(dev, b + bi);                         // 清零新块
        return b + bi;                              // 返回块号
      }
    }
    brelse(bp);
  }
  printk("balloc: out of blocks\n");
  return 0;                                          // 0 = 失败哨兵
}balloc从块0开始从前往后遍历整个位图,找到第1个空闲块就占用它,将其清空,并返回块号。代码比较难懂我详细解释一下
b表示块号,b每次增加BPB,即每次处理一整个位图块。BBLOCK(b, sb)计算出块号b对应的位图块号,读入该位图块bi表示位图块内的位号,bi每次增加1,直到BPB,即处理该位图块内的每一位,同时保证b + bi < sb.size,即不超过磁盘总块数- 读该块对应的位图位,决定是否占用
由于一开始硬盘boot block - bitmap都被占用,所以balloc会跳过这些块,找到第一个空闲块(通常是数据块)并占用它
bfree
// Free a disk block.
static void
bfree(int dev, uint b)
{
  struct buf *bp;
  int bi, m;

  bp = bread(dev, BBLOCK(b, sb));   // 找到该块所属的位图块
  bi = b % BPB;
  m = 1 << (bi % 8);
  if ((bp->data[bi / 8] & m) == 0)
    panic("freeing free block");     // 二次释放检测
  bp->data[bi / 8] &= ~m;            // 清 0:标记空闲
  log_write(bp);
  brelse(bp);
}bfree是balloc的逆操作,释放一个块。如果该块对应位图中的位是0,说明重复释放bug,panic报错
balloc和bfree调用的分配和释放的bread和brelse,管理了缓冲区的锁,天然互斥,因此不再需要额外的锁
inode
| 分类 | 函数 | 作用 |
|---|---|---|
| 分配 | ialloc | 磁盘上找空闲dinode,调用iget |
| 引用 | iget | 内存inode表中查找/新建条目;ref++;不读盘 |
| 锁 | ilock | 加睡眠锁;inode无效时从磁盘读 |
| 同步 | iupdate | 内存inode写入磁盘 |
| 释放 | iput | ref--;最后一个引用且nlink == 0时释放 |
| 寻址 | bmap | 找到文件数据块块号,可能分配新的 |
| 截断 | itrunc | 释放全部直接块与间接块 |
| 元信息 | stati | 供stat系统调用获取元数据 |
| 读内容 | readi | 从 off 读 n 字节到 dst |
| 写内容 | writei | 从 src 写 n 字节到 off,必要时分配新块并iupdate |
inode层函数可以分为下面几类
- 磁盘
dinode的分配与释放:ialloc,ifree(ifree释放磁盘dinode,这里没有详细讲) - 内存
inode的引用计数管理:iget,iput,idup - 内存
inode的锁与同步:ilock,iunlock - 内存与磁盘的
inode同步:iupdate - 文件内容的读写:
readi,writei,他们调用bmap;itrunc释放文件内容块
磁盘inode
磁盘inode即为存在磁盘上面的dinode结构体
struct dinode {
  short type;              // 文件类型;0 = 空闲
  short major;             // 主设备号(仅设备文件)
  short minor;             // 次设备号(仅设备文件)
  short nlink;             // 链接数:多少目录项指向它
  uint size;               // 内容字节数
  uint addrs[NDIRECT + 1]; // 数据块地址(12 直接 + 1 间接)
};它的大小是2 + 2 + 2 + 2 + 4 + (13 * 4) = 64字节,正好BSIZE / NINODE = 1024 / 16 = 64,即每块存放16个dinode,即IPB。相关的宏定义如下
#define IPB (BSIZE / sizeof(struct dinode))       // 16
#define IBLOCK(i, sb) ((i) / IPB + sb.inodestart) // 第 i 个 inode 所在块
内存inode
struct inode {
  uint dev;              // 设备号
  uint inum;             // inode 号
  int ref;               // 引用计数(内存指针数)
  struct sleeplock lock; // 保护下面所有字段
  int valid;             // 是否已从磁盘读入

  short type; // 以下都是 dinode 的副本
  short major;
  short minor;
  short nlink;
  uint size;
  uint addrs[NDIRECT + 1];
};从磁盘中读取的dinode会被缓存到内存中,添加额外数据变为inode。内存维护了一张inode表
struct {
  struct spinlock lock;
  struct inode inode[NINODE];   // NINODE = 50
} itable;inode有4种状态
- 是否已分配:磁盘
type是否非 0;ialloc分配,iput释放 - 是否在表中被引用:
ref > 0;iget加,iput减 - 内容是否有效:
valid;ilock读盘后置 1,iput归零时清 0 - 是否被锁:先
ilock才能读写字段和内容
inode锁
inode的两把锁管理的区域不同
itable.lock: 全局大锁,管理整个inode槽位的归属,即每个槽位的ref,dev,inum,valid字段inode.lock: 每个inode的睡眠锁,保护该inode的内容字段,即type,major,minor,nlink,size,addrs
inode只出现在三个函数iget, idup, iput中,他们操作的都是inode那些内存特有的字段。只要读写那些字段,必须持有itable.lock,读写完成立刻释放
inode.lock在读写inode的内容字段时使用
ialloc
ialloc与balloc类似,balloc尝试找到一个空闲块,ialloc尝试在硬盘中找到一个空闲的dinode
硬盘中dinode.type为0表示空闲,非0表示已分配
他最后会调用iget在内存中分配inode条目并返回
// Allocate an inode on device dev.
struct inode *
ialloc(uint dev, short type)
{
  int inum;
  struct buf *bp;
  struct dinode *dip;

  for (inum = 1; inum < sb.ninodes; inum++) {   // 从 1 号扫到最后一个
    bp = bread(dev, IBLOCK(inum, sb));          // IBLOCK 计算出该 inode 所在块号
    // bp->data读出整块的数据,有16个dinode,将其转为dinode *类型加上偏移得到该dinode的指针
    // data是uchar*类型,转为dinode *就指向第0个dinode
    dip = (struct dinode *)bp->data + inum % IPB;
    if (dip->type == 0) { // a free inode
      memset(dip, 0, sizeof(*dip));
      dip->type = type;                          // 标记类型
      log_write(bp);                             // 登记写盘
      brelse(bp);
      return iget(dev, inum);                    // 返回内存条目
    }
    brelse(bp);
  }
  printk("ialloc: no inodes\n");
  return 0;
}
iget
iget只操作内存inode表,不读盘,不加睡眠锁
dev是设备号,inum是磁盘上的dinode索引,返回内存inode表中对应的inode指针
static struct inode *
iget(uint dev, uint inum)
{
  struct inode *ip, *empty;

  acquire(&itable.lock);

  // Is the inode already in the table?
  empty = 0;
  for (ip = &itable.inode[0]; ip < &itable.inode[NINODE]; ip++) {
    if (ip->ref > 0 && ip->dev == dev && ip->inum == inum) {
      ip->ref++;                     // 命中:返回一个新引用
      release(&itable.lock);
      return ip;
    }
    if (empty == 0 && ip->ref == 0)  // 记住第一个空槽
      empty = ip;
  }

  if (empty == 0)
    panic("iget: no inodes");        // 表满

  ip = empty;                        // 复用空槽
  ip->dev = dev;
  ip->inum = inum;
  ip->ref = 1;
  ip->valid = 0;                     // 还没从磁盘读入
  release(&itable.lock);
  return ip;
}iget仅仅在内存inode表中查找或分配一个条目,没有建立与磁盘dinode的联系
&itable.lock保护整个内存inode表,使得一个inode最多只有一个条目
ilock
ilock加睡眠锁,如果数据无效从磁盘读入数据到内存inode中
相对的iunlock释放睡眠锁
void
ilock(struct inode *ip)
{
  struct buf *bp;
  struct dinode *dip;

  if (ip == 0 || ip->ref < 1)
    panic("ilock");

  acquiresleep(&ip->lock);      // 先拿睡眠锁

  if (ip->valid == 0) {         // 只在没读过时读盘
    bp = bread(ip->dev, IBLOCK(ip->inum, sb));
    dip = (struct dinode *)bp->data + ip->inum % IPB;  // 和ialloc的指针操作一致
    ip->type = dip->type;       // dinode -> 内存 inode
    ip->major = dip->major;
    ip->minor = dip->minor;
    ip->nlink = dip->nlink;
    ip->size = dip->size;
    memmove(ip->addrs, dip->addrs, sizeof(ip->addrs));
    brelse(bp);
    ip->valid = 1;
    if (ip->type == 0)
      panic("ilock: no type");
  }
}
iupdate
iupdate将内存inode写回磁盘dinode
void
iupdate(struct inode *ip)
{
  struct buf *bp;
  struct dinode *dip;

  bp = bread(ip->dev, IBLOCK(ip->inum, sb));
  dip = (struct dinode *)bp->data + ip->inum % IPB;
  dip->type = ip->type;                  // 内存 inode -> dinode
  dip->major = ip->major;
  dip->minor = ip->minor;
  dip->nlink = ip->nlink;
  dip->size = ip->size;
  memmove(dip->addrs, ip->addrs, sizeof(ip->addrs));
  log_write(bp);
  brelse(bp);
}每次改动会落盘的字段后都要调用iupdate,调用者必须持 ip->lock;
iput
iput释放一个内存inode引用,如果是最后一个引用且没有链接,就释放磁盘dinode和数据块
void
iput(struct inode *ip)
{
  acquire(&itable.lock);

  int last = (ip->ref == 1 && ip->valid && ip->nlink == 0); // 最后引用且无链接
  uint dev = ip->dev, inum = ip->inum;   // 先捕获,ref 归零后槽位可能被复用

  if (last) {
    acquiresleep(&ip->lock);
    release(&itable.lock);

    itrunc(ip);        // 释放数据块(磁盘上 type 暂时保留)
    ip->valid = 0;

    releasesleep(&ip->lock);

    acquire(&itable.lock);
  }

  ip->ref--;           // 放引用
  release(&itable.lock);

  if (last)
    ifree(dev, inum);  // 现在再把磁盘 dinode 的 type 清 0
}这里持有自旋锁时再次尝试获取睡眠锁是安全的,因为ref == 1表面没有其他线程在使用该inode,所以不可能有线程持有ip->lock,因而acquiresleep(&ip->lock)不会陷入睡眠而是直接获取锁之后返回
bmap
dinode.addrs存放了文件数据的磁盘块号,前0-11是直接块地址,直接指向数据块,12是间接块地址,指向的间接块另外存储了额外的数据块地址,每个地址4字节,一个块至多存256个地址
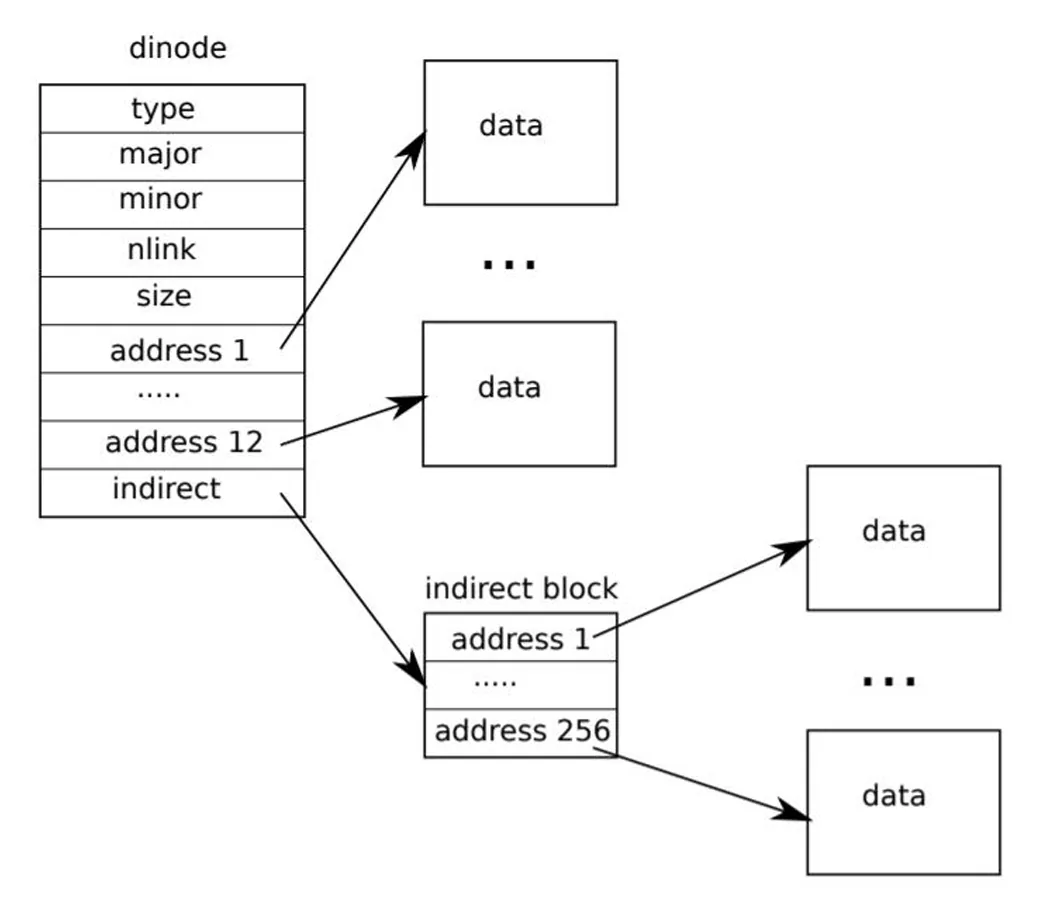
bmap函数包装了这种表示逻辑,其返回inode下第bn个数据块的磁盘块号,如果没有就分配一个新的数据块并返回
由于修改了inode.addrs,必须持有inode.lock
static uint
bmap(struct inode *ip, uint bn)
{
  uint addr, *a;
  struct buf *bp;

  if (bn < NDIRECT) {                 // 直接块区
    if ((addr = ip->addrs[bn]) == 0) {  // 槽是空的?
      addr = balloc(ip->dev);           // 分配一块
      if (addr == 0)
        return 0;                       // 磁盘满了
      ip->addrs[bn] = addr;             // 记下来
    }
    return addr;
  }
  bn -= NDIRECT;                      // 换成间接区下标,减12

  if (bn < NINDIRECT) {               // 间接块区,不能超过256
    // Load indirect block, allocating if necessary.
    if ((addr = ip->addrs[NDIRECT]) == 0) { // 还没有间接块?
      addr = balloc(ip->dev);         // 分配的新块都会清0
      if (addr == 0)
        return 0;
      ip->addrs[NDIRECT] = addr;
    }
    bp = bread(ip->dev, addr);            // 读入间接块
    a = (uint *)bp->data;                 // 当作 uint 数组
    if ((addr = a[bn]) == 0) {            // 该槽为空?
      addr = balloc(ip->dev);
      if (addr) {
        a[bn] = addr;                     // 写入新块号
        log_write(bp);                    // 记入日志
      }
    }
    brelse(bp);
    return addr;
  }

  panic("bmap: out of range");
}
itrunc
itrunc与bmap相反,作用是递归地释放inode下的所有数据块,其按照先直接块,再间接块对应的数据块,再间接块本身清理
void
itrunc(struct inode *ip)
{
  int i, j;
  struct buf *bp;
  uint *a;

  for (i = 0; i < NDIRECT; i++) {        // 先释放直接块
    if (ip->addrs[i]) {
      bfree(ip->dev, ip->addrs[i]);
      ip->addrs[i] = 0;                  // 清 0
    }
  }

  if (ip->addrs[NDIRECT]) {              // 有间接块吗?
    bp = bread(ip->dev, ip->addrs[NDIRECT]);
    a = (uint *)bp->data;
    for (j = 0; j < NINDIRECT; j++) {    // 释放间接块指向的数据块
      if (a[j])
        bfree(ip->dev, a[j]);
    }
    brelse(bp);
    bfree(ip->dev, ip->addrs[NDIRECT]);  // 最后释放间接块本身
    ip->addrs[NDIRECT] = 0;
  }

  ip->size = 0;
  iupdate(ip);
}
stati
stati是stat系统调用的实现,返回文件的元信息
void
stati(struct inode *ip, struct stat *st)
{
  st->dev   = ip->dev;
  st->ino   = ip->inum;
  st->type  = ip->type;
  st->nlink = ip->nlink;
  st->size  = ip->size;
}
readi
readi意图从inode为ip的文件,文件内字节偏移off开始读,一共读n个字节,将内容拷贝到dst地址上面的缓冲区上。如果user_dst == 1,那么dst就是用户地址,否则为内核地址
int
readi(struct inode *ip, int user_dst, uint64 dst, uint off, uint n)
{
  uint tot, m;
  struct buf *bp;

  if (off > ip->size || off + n < off)  // 起点越界,或 n 溢出
    return 0;
  if (off + n > ip->size)               // 读过了文件末尾
    n = ip->size - off;                 // 缩短读取长度

  for (tot = 0; tot < n; tot += m, off += m, dst += m) {  // 主循环
    uint addr = bmap(ip, off / BSIZE);  // 文件块号 -> 磁盘块号
    if (addr == 0)
      break;                            // 分配失败就停
    bp = bread(ip->dev, addr);          // 读磁盘块
    m = min(n - tot, BSIZE - off % BSIZE);  // 本次能拷多少字节
    if (either_copyout(user_dst, dst, bp->data + (off % BSIZE), m) == -1) {
      brelse(bp);                       // 用户地址非法
      tot = -1;
      break;
    }
    brelse(bp);
  }
  return tot;                           // 实际读到的字节数
}开头检查off是否在文件内,以及n是否溢出。之后对于要读取的字节数超过文件末尾剩余长度的情况,缩减n
之后在主循环中,通过bmap找到对应的数据块号,用bread读磁盘块,算出本次能拷贝多少个字节(剩余需要拷贝的数量n - tot,与当前块中偏移off剩下的字节数的较小值),执行拷贝
由于off检查后一定小于ip->size,所以bmap不会分配新块
writei
int
writei(struct inode *ip, int user_src, uint64 src, uint off, uint n)
{
  uint tot, m;
  struct buf *bp;

  if (off > ip->size || off + n < off)
    return -1;
  if (off + n > MAXFILE * BSIZE)        // 不能超过文件最大长度
    return -1;

  for (tot = 0; tot < n; tot += m, off += m, src += m) {
    uint addr = bmap(ip, off / BSIZE);
    if (addr == 0)
      break;
    bp = bread(ip->dev, addr);
    m = min(n - tot, BSIZE - off % BSIZE);
    if (either_copyin(bp->data + (off % BSIZE), user_src, src, m) == -1) {
      log_write(bp);                    // 可能已改了半个块,要记日志
      brelse(bp);
      break;
    }
    log_write(bp);                      // 把修改记入日志
    brelse(bp);
  }

  if (off > ip->size)                   // 写使文件长大了?
    ip->size = off;                     // 更新大小
  iupdate(ip);                          // 写回 inode
  return tot;
}writei执行写文件,在超过文件末尾但是没有超过文件上限(所有的直接块与间接块对应的数据块)的情况下分配新的数据块
目录层
目录结构
XV6的设计与Unix理念类似,目录被视为一种特殊的文件,数据排布方式与普通文件相同(直接块+间接块),但是其数据为dirent结构体数组,每个dirent表示一个目录项,包含文件名和对应的inode号。一个结构体大小16字节,一块能存64个目录项
#define DIRSIZ 14

struct dirent {
  ushort inum;                            // 2 字节
  char name[DIRSIZ] __attribute__((nonstring)); // 14 字节
};inum是目录号,回顾之前便是磁盘上inode区的索引号,为0表示该槽位空闲;name是文件名,长度至多14字节
- 当文件名小于14字节时,
name后面补\0 - 当文件名大于等于14字节时,
name不补\0,只取前14字节
因此比较两个文件名是否相等时,不能使用普通的字符串比较函数,XV6包装了一个namecmp函数,比较两个文件名是否相等
int namecmp(const char *s, const char *t) {
  return strncmp(s, t, DIRSIZ);   // 固定只比 14 字节,不靠 \0
}每个目录通常前两项是..和.,分别表示父目录和当前目录。在创建目录时写入。根目录的..指向自己
dirlookup
dirlookup在目录dp中查找文件名为name的目录项,如果找到就返回对应的inode
找到的方式是通过iget返回对应的inode项,不会持有对应的inode.lock,只是将ref++,拿锁需要靠ilock
struct inode *
dirlookup(struct inode *dp, char *name, uint *poff)
{
  uint off, inum;
  struct dirent de;

  if (dp->type != T_DIR)
    panic("dirlookup not DIR");

  for (off = 0; off < dp->size; off += sizeof(de)) {
    if (readi(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
      panic("dirlookup read");
    if (de.inum == 0)
      continue;                       // 空槽,跳过
    if (namecmp(name, de.name) == 0) {
      if (poff)
        *poff = off;                  // 告诉调用者:条目在第 off 字节
      inum = de.inum;
      return iget(dp->dev, inum);     // 返回"已引用但未锁定"的 inode
    }
  }

  return 0;                           // 没找到
}dirlookup返回的inode没有锁定的原因在于
- 调用
dirlookup之前的dp已经被调用者锁住,如果传入.查找本身,如果dirlookup返回的.试图加锁,就是又给自己加锁,就会陷入死锁 - 如果传入
..可能会更复杂,例如父目录去查子目录,子目录想拿父目录,调用dirlookup之前各自都锁住了,那么就会死锁
这只是简单的情况,还有更复杂的,为了降低复杂性,dirlookup不主动加锁
dirlink
dirlink在目录dp中创建一个新的目录项,名字为name,对应的inode号为inum
int
dirlink(struct inode *dp, char *name, uint inum)
{
  int off;
  struct dirent de;
  struct inode *ip;

  // 1) 先查重:名字已存在就报错
  if ((ip = dirlookup(dp, name, 0)) != 0) {
    iput(ip);
    return -1;
  }

  // 2) 找一个空闲槽位
  for (off = 0; off < dp->size; off += sizeof(de)) {
    if (readi(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
      panic("dirlink read");
    if (de.inum == 0)
      break;                          // 找到空槽,off 停在它的偏移
  }

  // 3) 写进去
  strncpy(de.name, name, DIRSIZ);
  de.inum = inum;
  if (writei(dp, 0, (uint64)&de, off, sizeof(de)) != sizeof(de))
    return -1;

  return 0;
}注意off分几种情况
for循环中找到了空槽,off直接指向空槽的偏移,可以直接写入for循环中没有找到空槽,off会等于dp->size,此时直接指向文件末尾,也就是第一个空闲的数据块,writei会自动分配新的数据块并写入
不会出现写出界(也就是超过最大文件限制)的情况,因为writei检查出界返回-1,走入if分支返回-1
路径名层
namex是路径名层的核心函数,其通过path查找对应的inode,如果nameiparent == 1,则返回最后一个元素的父目录的inode,否则返回最后一个元素的inode
核心在于调用skipelem,这个函数将路径名的第一个元素拷贝到name中,并返回剩余路径名的指针。namex循环调用skipelem,每次处理一个路径元素,直到走到最后一个元素
static struct inode *
namex(char *path, int nameiparent, char *name)
{
  struct inode *ip, *next;

  // 起点
  if (*path == '/')
    ip = iget(ROOTDEV, ROOTINO);      // 绝对路径:根目录 inode 1
  else
    ip = idup(myproc()->cwd);         // 相对路径:当前工作目录

  // 一个元素一个元素地走
  while ((path = skipelem(path, name)) != 0) {
    ilock(ip);                        // 锁住当前目录
    if (ip->type != T_DIR) {          // 必须是目录
      iunlockput(ip);
      return 0;
    }
    if (ip->nlink == 0) {             // 已被删除的目录
      iunlockput(ip);
      return 0;
    }
    if (nameiparent && *path == '\0') {  // 最后一个元素就停
      iunlock(ip);
      return ip;
    }
    if ((next = dirlookup(ip, name, 0)) == 0) {  // 找下一层
      iunlockput(ip);
      return 0;
    }
    iunlockput(ip);                   // 先放当前,再
    ip = next;                        // 把 next 留到下一轮再锁
  }

  if (nameiparent) {                  // 走到头却不是最后一个元素
    iput(ip);
    return 0;
  }
  return ip;
}
描述符层
struct file {
  enum { FD_NONE, FD_PIPE, FD_INODE, FD_DEVICE } type;
  int ref;              // reference count  引用计数
  char readable;
  char writable;
  struct pipe *pipe;    // FD_PIPE
  struct inode *ip;     // FD_INODE and FD_DEVICE
  uint off;             // FD_INODE   读写偏移量
  short major;          // FD_DEVICE
};对于每一个进程而言,都有一个自己独有的fd文件描述符表,这个表是一个数组,存储指向file结构体的指针
struct file *ofile[NOFILE]平时调用open等拿到的文件描述符整数,就是这个数组的索引
对于系统全局有一个ftable,所有进程共用。真正的file结构体存储在这个表中
struct file file[NFILE]进程的文件描述符表中的指针指向全局ftable中的file结构体,使得多个描述符,甚至多个进程,可以共享同一个file结构体
每次调用open时实际在全局ftable中分配一个file结构体,因此就算两次open同一个文件,其file结构体中的偏移量off也是独立的,互不影响
dup在进程的文件描述符表中分配一个新的索引,指向同一个file结构体,因此共享偏移量off,互相影响
fork直接拷贝整个文件描述符表,父子进程指向的file结构体是同一个