虚拟内存
内存访问
当分页开启后,CPU 的每条访存指令都只认虚拟地址。它会被 MMU (Memory Management Unit) 翻译成物理地址再去访问内存
MMU是CPU的一部分硬件,自动实现将虚拟地址映射到物理地址的功能。CPU发出的地址会先经过MMU,再输出去访问内存
不存在”绕过页表直接摸物理内存”的 S/U 模式访存指令
内存映射
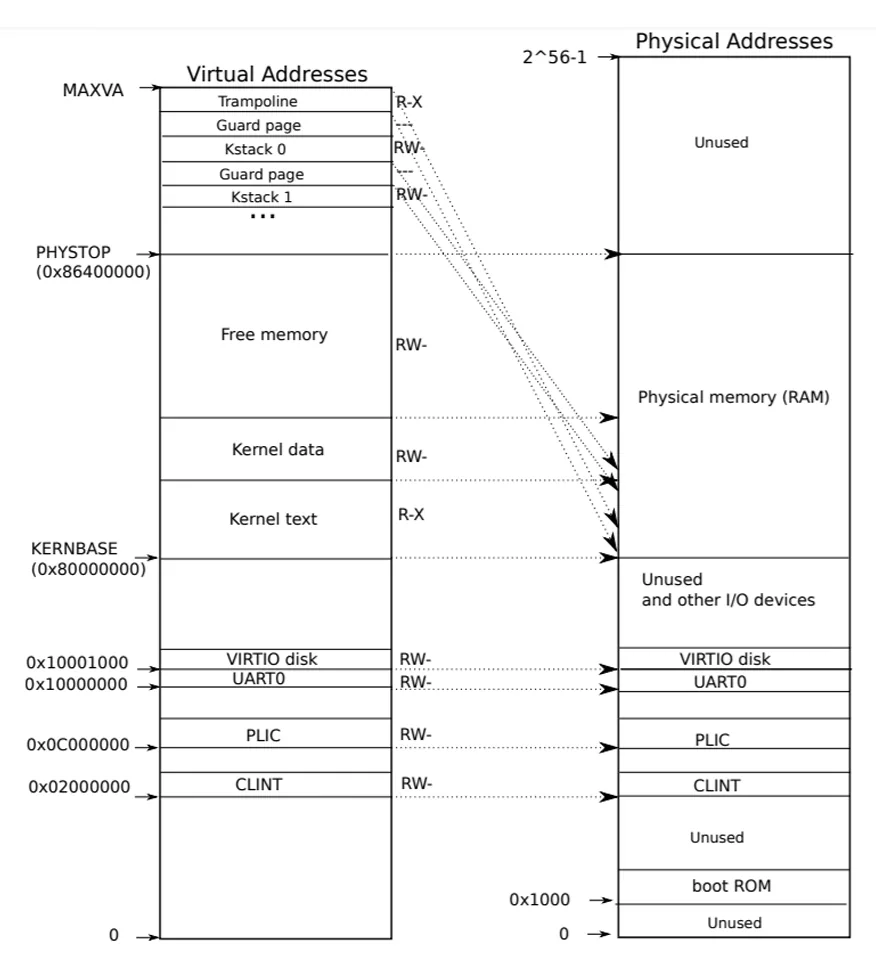
xv6 把整段物理 RAM(0x80000000 ~ 0x88000000,128MB)恒等映射进内核页表。内核页表中虚拟地址与物理地址相等
因此内核能直接通过地址访问物理内存
页表结构
xv6 运行在 Sv39 RISC-V 上。64位虚拟内存空间中,只有底部39位被使用,被切成5段
63──────39   38──────30  29──────21  20──────12  11──────0
│ 必须全0   │ level-2  │ level-1  │ level-0  │ 页内偏移  │
             9bit      9bit      9bit      12bit
这意味着每一个页表一共有 个页表项,每个页表项占8字节,页表大小为 字节,也就是一页
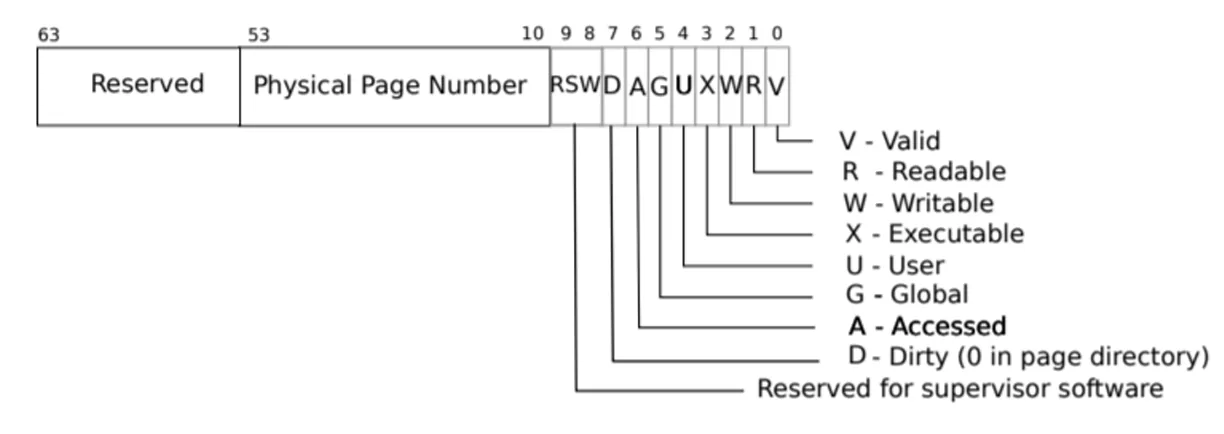
页表中的一项被称为PTE(Page Table Entry),包括物理页号和标志位
PTE内容随页表等级而不同,可以分为两种
- 中间层 PTE(R/W/X 全 0,只置 V)→ 指向下一级页表页
- 叶子 PTE(R/W/X 至少 1 个)→ 指向真正的物理数据页
MMU机制
MMU是否执行翻译由以下决定
satp.MODE字段:satp是CPU用来存根页表地址的寄存器。寄存器中的某几位为Mode字段,表示当前使用的页表模式。0 = Bare(直通,地址当物理地址用);8 = Sv39(三级页表翻译)- 特权级:M 模式恒不翻译;S/U 模式看 satp.MODE
页表操作函数
页表初始化的核心在于walk()函数和mappages()函数。walk()依据虚拟地址一级一级查找对应的页表项,但是不会建立虚拟和物理的映射关系。mappages()会调用walk(),在查找页表项的同时建立虚拟和物理的映射关系
walk()
// 返回虚拟地址 va 在第0级页表里的 PTE 的【地址】。
// 如果中间层页表页缺失且 alloc!=0,现场分配并挂接。
pte_t *
walk(pagetable_t pagetable, uint64 va, int alloc)
{
  if (va >= MAXVA)
    panic("walk");                                  // 地址超出Sv39合法范围

  for (int level = 2; level > 0; level--) {         // 只处理第2、1级
    pte_t *pte = &pagetable[PX(level, va)];         // 用"这一级对应的9位"当下标
    if (*pte & PTE_V) {                             // 有效 → 下一级页表已存在
      pagetable = (pagetable_t)PTE2PA(*pte);        //   顺着跳到下一级页表页
    } else {                                        // 无效 → 下一级页表页不存在
      if (!alloc || (pagetable = (pde_t *)kalloc()) == 0)
        return 0;                                   //   不允许建,或内存耗尽 → 返回0
      memset(pagetable, 0, PGSIZE);                 //   新建的页表页清零
      *pte = PA2PTE(pagetable) | PTE_V;             //   把新页表页地址写回父PTE
    }
  }
  return &pagetable[PX(0, va)];                     // 停在level 0,返回叶子PTE地址
}walk()函数根据页表查找规则,从根页表开始,逐级查找虚拟地址对应的页表项。如果某一级的页表项不存在,则根据alloc参数决定是否分配新的页表页
walk()查找到最终的叶子页表项后,并不会写入表项建立虚拟和物理的映射关系。它只返回叶子页表项的地址,供调用者使用
也就是说,walk() 只保证”通往叶子 PTE 的路通了”(树结构存在)
mappages()
// 把虚拟区间 [va, va+size) 逐页映射到物理区间 [pa, pa+size)。
// 前提: va、size 都页对齐。
int
mappages(pagetable_t pagetable, uint64 va, uint64 size, uint64 pa, int perm)
{
  uint64 a, last;
  pte_t *pte;

  if ((va % PGSIZE) != 0)   panic("mappages: va not aligned");   // 前置断言
  if ((size % PGSIZE) != 0) panic("mappages: size not aligned");
  if (size == 0)            panic("mappages: size");

  a = va;
  last = va + size - PGSIZE;                     // 最后一个待映射页的起始
  for (;;) {
    if ((pte = walk(pagetable, a, 1)) == 0)      // ① 修路(缺中间页表就建)
      return -1;
    if (*pte & PTE_V)
      panic("mappages: remap");                  // ② 防同一虚拟页重复映射
    *pte = PA2PTE(pa) | perm | PTE_V;            // ③ 核心: 把数据页写进叶子PTE
    if (a == last)
      break;
    a += PGSIZE;                                 // ④ 虚拟地址前进一页
    pa += PGSIZE;                                //    物理地址同步前进一页
  }
  return 0;
}mappages()函数在调用walk()的同时,把物理页号写入叶子页表项,建立虚拟和物理的映射关系。它会检查虚拟地址和大小是否页对齐,并防止同一虚拟页被重复映射
内存分配器
XV6的内存分配器是一个简单的单向空闲链表,其每一项都是4096字节的页
内核在启动时调用kinit()初始化内存分配器,建立空闲链表。之后内核通过kalloc()从链表头部取出一个页作为物理页返回,或者通过kfree()把一个页放回链表头部
数据结构
// kalloc.c:17-24
struct run {                    // 空闲页链表节点
  struct run *next;
};

struct {
  struct spinlock lock;         // 保护下面这个链表头
  struct run *freelist;         // 空闲页链表头
} kmem;                         // 全局唯一,所有CPU共享
struct run 节点就存在空闲页自己的前 8 个字节里。
空闲页里没有数据,正好借首 8 字节存 next 指针。链上每个节点就是一块空闲物理页本身
kinit()
// kalloc.c:26-40
extern char end[];              // kernel.ld: 内核映像结束地址

void kinit() {
  initlock(&kmem.lock, "kmem");
  freerange(end, (void *)PHYSTOP);      // 把 [end, PHYSTOP) 全部交给kfree
}

void freerange(void *pa_start, void *pa_end) {
  char *p;
  p = (char *)PGROUNDUP((uint64)pa_start);  // 对齐到页边界(PTE只能引用4096对齐)
  for (; p + PGSIZE <= (char *)pa_end; p += PGSIZE)
    kfree(p);                                // 一页一页加入空闲链表
}
注意:
end之前是内核自己的代码/数据,不进空闲链表- xv6 不解析硬件配置探测内存,直接假设 128MB(
PHYSTOP = KERNBASE + 128MB) PGROUNDUP确保只加入整页(页表 PTE 只能引用 4096 对齐的物理地址)
kfree()
// kalloc.c:47-63
void kfree(void *pa) {
  struct run *r;

  if (((uint64)pa % PGSIZE) != 0 || (char *)pa < end || (uint64)pa >= PHYSTOP)
    panic("kfree");               // 合法性检查: 对齐/不低于内核/不越界

  memset(pa, 1, PGSIZE);          // ★ 毒化: 整页填0x01, 逼悬空引用bug暴露

  r = (struct run *)pa;           // 把物理地址当作run指针
  acquire(&kmem.lock);
  r->next = kmem.freelist;        // 头插法: 新节点指向旧表头
  kmem.freelist = r;              // 自己成为新表头
  release(&kmem.lock);
}kfree()把一页物理内存放回空闲链表的头部。它会检查页的合法性,并用0x01填充整页,逼迫悬空引用的bug暴露
kalloc()
// kalloc.c:68-82
void *kalloc(void) {
  struct run *r;

  acquire(&kmem.lock);
  r = kmem.freelist;              // 取表头
  if (r)
    kmem.freelist = r->next;      // 摘走第一页(摘了即独占)
  release(&kmem.lock);

  if (r)
    memset((char *)r, 5, PGSIZE); // 分配出去前也毒化(填0x05), 让未初始化bug暴露
  return (void *)r;               // 返回物理地址; 0 = 内存耗尽
}kmalloc()从空闲链表头部取出一页物理内存返回。它会用0x05填充整页,逼迫未初始化的bug暴露
页表初始化
总览
最开始时,系统运行在M模式,直接跑在物理内存上
运行到main()函数,CPU0执行kinit(),kvminit()初始化全局的内核页表,随后执行kvminithart()设置自己的satp寄存器
CPU0执行完毕userinit()后,其余CPU执行自己的kvminithart(),设置自己的satp寄存器
entry.S → start()
// start.c:15-52(每个hart独立执行)
void start() {
  // ...
  w_satp(0);                    // 分页关闭(bare); 为进入S模式做准备
  // ...
  int id = r_mhartid();
  w_tp(id);                     // ★把自己的hartid存进tp寄存器(后面cpuid()用它)
  // ...
  asm volatile("mret");         // 切到S模式, 跳进main()
}
main()
// main.c:11-45
void main() {
  if (cpuid() == 0) {                       // 只有0号核走这里
    consoleinit();
    printkinit();
    kinit();            // 物理页分配器
    kvminit();          // 创建内核页表(kvmmake)
    kvminithart();      // 打开分页(CPU0自己的satp)
    procinit();         // 进程表初始化
    trapinit(); trapinithart();
    plicinit(); plicinithart();
    binit(); iinit(); fileinit(); virtio_disk_init();
    userinit();         // ★创建第一个用户进程(pid 1) — 放行前要有可运行进程
    __atomic_store_n(&started, 1, __ATOMIC_RELEASE);   // ★放行从核(release语义)
  } else {
    while (__atomic_load_n(&started, 1, __ATOMIC_ACQUIRE) == 0)
      ;                                 // 从核自旋等待CPU0建好一切
    printk("hart %d starting\n", cpuid());
    kvminithart();      // 从核各自打开分页(装同一张共享内核表)
    trapinithart(); plicinithart();
  }
  scheduler();          // 所有核最后都到这里
}CPU0调用kinit()初始化内存分配器,调用kvminit()创建内核页表,调用kvminithart()设置自己的satp寄存器打开分页
全部完成之后,其他CPU才会从自旋等待中醒来,调用kvminithart()设置自己的satp寄存器打开分页。此后所有CPU都进入调度器,开始调度进程运行
kvminit()
// vm.c:66-70
// 内核页表全局变量, 所有CPU共享。
pagetable_t kernel_pagetable;

void
kvminit(void)
{
  kernel_pagetable = kvmmake();   // 只做一件事: 建好表, 存进全局变量
}kvminit()函数调用kvmmake()创建内核页表,并把页表地址存进全局变量kernel_pagetable。所有CPU共享同一张内核页表
kvminit 本身极薄——真正的活全在 kvmmake(vm.c:22)
kvmmake()
// vm.c:22-53
pagetable_t
kvmmake(void)
{
  pagetable_t kpgtbl;

  kpgtbl = (pagetable_t)kalloc();        // ① 分配一页物理内存当根页表页
  memset(kpgtbl, 0, PGSIZE);             //    清零

  // 设备MMIO(恒等映射: va==pa)
  kvmmap(kpgtbl, UART0,    UART0,    PGSIZE,    PTE_R | PTE_W); // 串口
  kvmmap(kpgtbl, VIRTIO0,  VIRTIO0,  PGSIZE,    PTE_R | PTE_W); // 磁盘
  kvmmap(kpgtbl, PLIC,     PLIC,     0x4000000, PTE_R | PTE_W); // 中断控制器

  // 内核代码段: 只读+可执行
  kvmmap(kpgtbl, KERNBASE, KERNBASE, (uint64)etext - KERNBASE, PTE_R | PTE_X);
  // 内核数据 + 全部物理RAM: 可读写(恒等映射整段RAM)
  kvmmap(kpgtbl, (uint64)etext, (uint64)etext, PHYSTOP - (uint64)etext,
         PTE_R | PTE_W);

  // trampoline: 映射到最高虚拟地址(非恒等)
  kvmmap(kpgtbl, TRAMPOLINE, (uint64)trampoline, PGSIZE, PTE_R | PTE_X);

  // 给64个进程槽位预铺内核栈
  proc_mapstacks(kpgtbl);

  return kpgtbl;
}
kvmmake 内部其实反复用三个动作拼出整张内核表:
| 动作 | 用什么 | 干一次/循环干 |
|---|---|---|
| 分一页内存 | kalloc() | 根页表页,一次 |
| 建一段映射 | kvmmap(va, pa, size, perm) | UART / VIRTIO / PLIC / 内核text / RAM / TRAMPOLINE |
| 铺内核栈 | proc_mapstacks(kpgtbl) | 内部循环 64 次,每槽位一次 kvmmap |
对于每一个进程槽位(一共64个),通过调用proc_mapstacks(),在内核页表顶部区域放内核栈与守护页,间隔放置
内核栈会分配映射物理页,守卫栈直接不映射,页表中找不到,因此访问守卫页会触发缺页异常,保护内核栈不被溢出
MAXVA(0x400000000)
 [trampoline  ]  最高1页
 [TRAPFRAME   ]  用户表里映射(trap存用户寄存器)
 [stack0  ]  ← KSTACK(0), 映射(栈顶在页的高端)
 [guard0  ]  ← 无映射(守护页, 纯虚拟空档, 不占物理内存)
 [stack1  ]  ← KSTACK(1)
 [guard1  ]  ← 无映射
 ...
kvminithart()
void
kvminithart()
{
  sfence_vma();                                   // ① 冲刷(见下)
  w_satp(MAKE_SATP(kernel_pagetable));            // ② 写satp, 开分页
  sfence_vma();                                   // ③ 再冲刷
}sfence_vma()是RISC-V的指令,冲刷TLB,避免读到过期的页表项
一个常见误解的澄清:“会不会在写完页表、sfence 之前有别人读到旧 TLB?”
- 单核上不会:因为 MMU 只在访存指令需要翻译时才查页表,而正确代码把”写表 → sfence → 首次使用”按程序顺序排好,中间没有会触发翻译并依赖新映射的指令
- 真正的并发风险在多核共享表——但那需要”两个核同时改一张表”,xv6 从设计上杜绝了这种场景
sbrk
调用链
用户: sbrk(n) → syscall → sys_sbrk(sysproc.c:40) → growproc(proc.c:236)
   n>0 → uvmalloc(vm.c:218)    n<0 → uvmdealloc(vm.c:249) → uvmunmap(vm.c:194)
sys_sbrk()
提取参数,调用growproc()
// sysproc.c:40-65
uint64 sys_sbrk(void) {
  uint64 addr;
  int t, n;

  argint(0, &n);
  argint(1, &t);
  addr = myproc()->sz;

  if (t == SBRK_EAGER || n < 0) {          // 急切分配(或收缩)
    if (growproc(n) < 0) return -1;
  } else {
    // 惰性分配: 只加大p->sz, 不真正分配; 等用户访问触发vmfault再补
    if (addr + n < addr) return -1;
    if (addr + n > TRAPFRAME) return -1;
    myproc()->sz += n;
  }
  return addr;                              // 返回旧sz(即新堆的起始地址)
}
growproc()
依照参数分流,n > 0 调用 uvmalloc() 分配新页,n < 0 调用 uvmdealloc() 收缩页
int
growproc(int n)
{
  uint64 sz;
  struct proc *p = myproc();

  sz = p->sz;                               // 进程"已声明的用户内存大小"
  if (n > 0) {
    if (sz + n > TRAPFRAME) return -1;      // 上限: 堆不能撞到顶部用户区
    if ((sz = uvmalloc(p->pagetable, sz, sz + n, PTE_W)) == 0)
      return -1;                            // 增长失败(内存耗尽)
  } else if (n < 0) {
    sz = uvmdealloc(p->pagetable, sz, sz + n);   // 收缩
  }
  p->sz = sz;
  return 0;
}
uvmalloc()
根据oldsz和newsz,逐页分配物理页并建立映射。每次分配一页物理内存后,调用mappages()把虚拟页映射到新分配的物理页
// vm.c:218-242
uint64
uvmalloc(pagetable_t pagetable, uint64 oldsz, uint64 newsz, int xperm)
{
  char *mem;
  uint64 a;

  if (newsz < oldsz) return oldsz;
  oldsz = PGROUNDUP(oldsz);                  // 对齐到页边界
  for (a = oldsz; a < newsz; a += PGSIZE) {
    mem = kalloc();                          // ① 分配物理页
    if (mem == 0) { uvmdealloc(...); return 0; }
    memset(mem, 0, PGSIZE);                  // ② 清零(新内存必须为0)
    if (mappages(pagetable, a, PGSIZE, (uint64)mem, PTE_R | PTE_U | xperm) != 0) {...}
  }
  return newsz;
}
uvmdealloc()
调用uvmunmap()逐页解除映射,释放物理页
// vm.c:249-260
uint64
uvmdealloc(pagetable_t pagetable, uint64 oldsz, uint64 newsz)
{
  if (newsz >= oldsz) return oldsz;
  if (PGROUNDUP(newsz) < PGROUNDUP(oldsz)) {
    int npages = (PGROUNDUP(oldsz) - PGROUNDUP(newsz)) / PGSIZE;
    uvmunmap(pagetable, PGROUNDUP(newsz), npages, 1);
  }
  return newsz;
}

// vm.c:194-213
void
uvmunmap(pagetable_t pagetable, uint64 va, uint64 npages, int do_free)
{
  uint64 a;
  pte_t *pte;

  for (a = va; a < va + npages * PGSIZE; a += PGSIZE) {
    if ((pte = walk(pagetable, a, 0)) == 0) continue;  // 没有PTE就跳过
    if ((*pte & PTE_V) == 0) continue;                 // PTE无效也跳过
    if (do_free) {
      uint64 pa = PTE2PA(*pte);     // ★ 从PTE反推物理地址
      kfree((void *)pa);            //    归还freelist
    }
    *pte = 0;                       // 清掉映射
  }
}
exec
ELF可执行文件结构
┌─────────────────────────────┐  文件偏移0
│  ELF header (elfhdr)        │  第一个字段是魔数; 记录 phoff/phnum/entry 等
├─────────────────────────────┤
│  Program header table       │  ← 偏移 = ehdr.phoff, 共 phnum 个 proghdr
│  (加载器/exec 用这套)        │     (执行视图)
├─────────────────────────────┤
│  .text / .data / .bss...    │  真正的内容(LOAD段的内容在这)
├─────────────────────────────┤
│  Section header table       │  ← 偏移 = ehdr.shoff
│  (链接器/调试器用这套)        │     (链接视图)
└─────────────────────────────┘
多个具有相同读写执行权限的节,被“打包”在一起,就组成了一个段
- Section(节):链接视图,给链接器/调试器看(.text .data .bss .symtab);
- Segment(程序头 / proghdr):执行视图,给加载器(exec)看
kexec()
由于代码太长,这里只列出主要流程
kexec()的主要工作就是把ELF文件中的LOAD段搬到新的页表之中,复制参数到栈里面。之后设置好进程的新页表、入口地址和栈顶,释放旧映像的物理内存
- 打开文件:按路径找到可执行文件。
- 验明正身:读文件头,确认魔数是 \x7FELF,不是就不认。
- 建新页表:从零搭一张空用户页表(只带 trampoline/trapframe 两个固定映射)。
- 加载代码数据:遍历 ELF 的每个 LOAD 段——先分配内存(含清零的 .bss),再从文件把内容拷进去。搬完程序就”在内存里了”。
- 搭用户栈:在程序段上方放一页守护页(用户不可碰),再往上盖真正的栈。
- 压参数:把 argv 字符串和指针数组拷进栈里,argc 留作返回值、argv 地址放进 a1。
- 提交:确认全部成功后才”换皮”——换上这张新页表、设入口地址 epc = elf.entry、设 sp = 新栈顶,然后才把旧映像的物理内存全部释放。
- 返回:return argc。系统调用返回时 sret 会跳到 epc,进程就以新程序的身份开始执行。