上一讲的光栅化只回答了“哪些像素被三角形覆盖”。像素要显示颜色,还要回答两个问题:这个像素看到的是哪一层表面,这一点收到多少光;前者由深度测试解决,后者由着色解决。这一讲先补上 Z-buffer,再讲 Blinn-Phong 的三束光,然后进入纹理映射、双线性插值和 mipmap。
深度测试与 Z-buffer
画家算法把三角形按远近排序,从远到近画,近的覆盖远的。它的问题在排序:三个三角形可以互相遮挡成环,找不到全局的先后顺序,按三角形排序也处理不了互相穿插的表面,排序本身还要 。
Z-buffer 换一个思路:不为三角形排序,而是为每个像素记录当前最近的深度。它需要两块缓冲,帧缓冲存颜色,深度缓冲(z-buffer)存深度。
深度值有两种常见约定。课件把 当作沿视线方向的正距离,数值越小越近;上一讲的投影把 压进 ,近平面在 、远平面在 ,同样是数值越小越近。两种写法只差一个平移和缩放,比较方向一致。
伪代码里的 z 按正距离处理:
初始化 zbuf 为 +∞
for 每个三角形 T:
  for T 覆盖的每个样本 (x, y):
    z = T 在该样本处的深度
    if z < zbuf[x][y]:
      zbuf[x][y] = z
      framebuffer[x][y] = shade(T, x, y)
每个像素只保留最近的深度,后面的三角形可以任意顺序到达,先画的被挡住也没关系。每个三角形覆盖的样本各处理一次,总代价与所有三角形覆盖的样本数之和成正比,不需要排序,也容易并行。
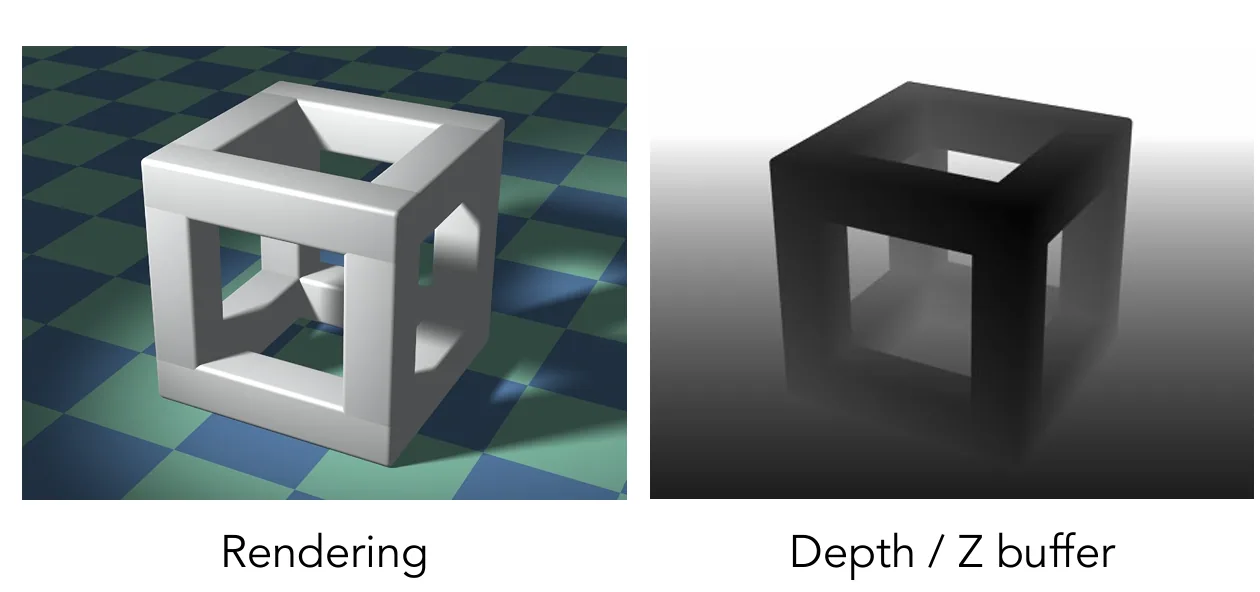
深度缓冲要为每个像素额外存一个深度值,显存与帧缓冲同一量级。开了 MSAA 后,深度也按子样本存储,每个子样本各自比较。
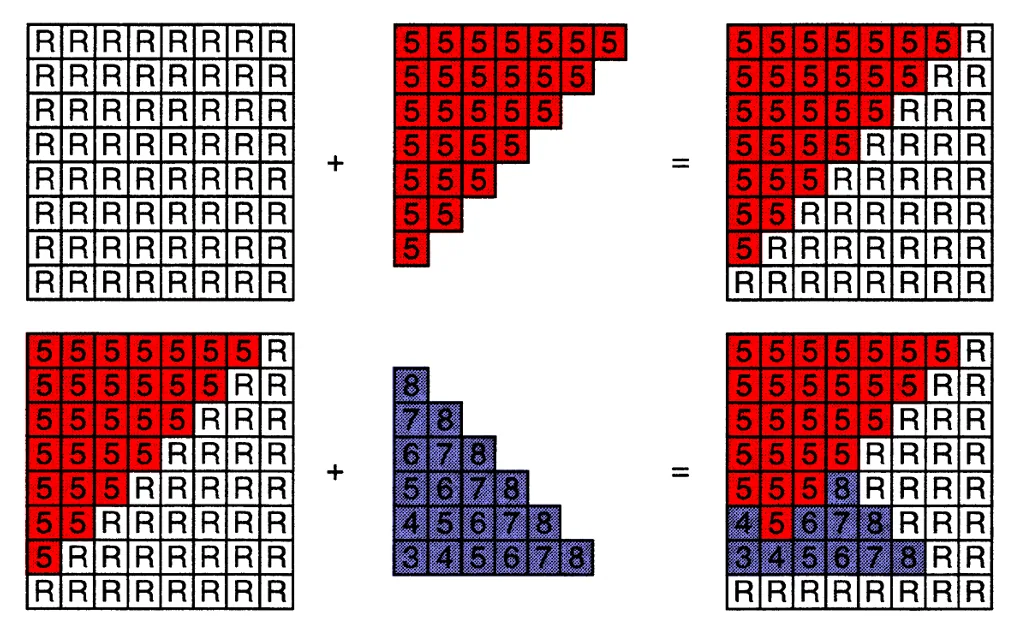
Z-buffer 每个像素只保留一层,透明物体需要按从远到近排序后混合,或者用别的结构;它也不处理折射和多次反弹,那些要等到光线追踪。
着色:Blinn-Phong 反射模型
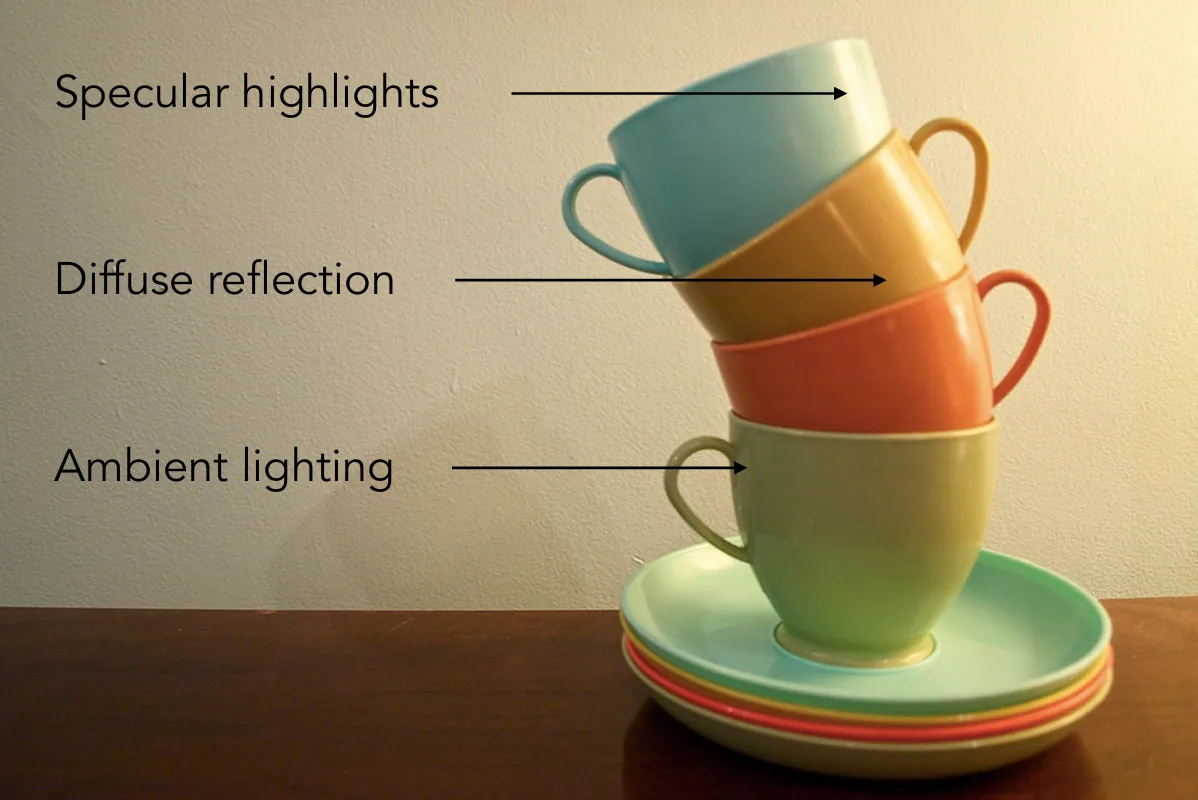
着色要算表面上某一点朝观察者发出的颜色。真实的光传输包含多次反弹,这里只做局部光照:每个点独立计算,不考虑阴影、互反射和折射。Blinn-Phong 是一个经验模型,把进入眼睛的光拆成环境光、漫反射和镜面反射三部分。
向量与符号
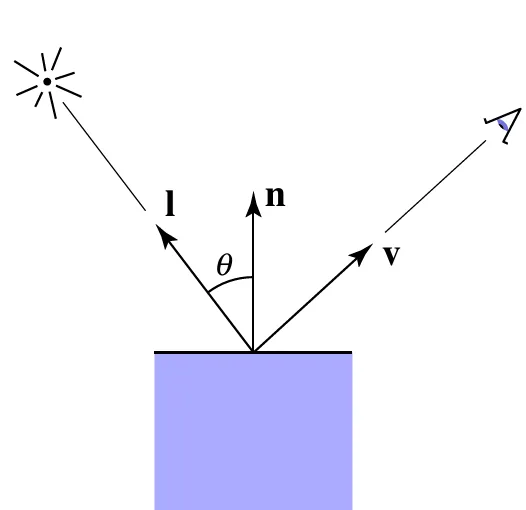
是单位法线, 是从着色点指向光源的单位向量, 是从着色点指向观察者的单位向量; 是 与 的半程向量:
其中 是光源强度, 是光源到着色点的距离; 是三个系数, 控制高光锐度。
环境光
环境光假设场景里有一层均匀的间接光,方向各向同性:
它不依赖法线、光源方向和观察方向,只给暗部一个底色。真实间接光不是常数,这一项是为了让模型简单可用。
漫反射
漫反射来自光线进入表面后向各方向均匀散射。接收到的能量与光线和表面的夹角有关:同样一束光,垂直照射时单位面积接收最多,斜射时被摊到更大面积上,单位面积接收的能量按 减少。这就是 Lambert 余弦定律:
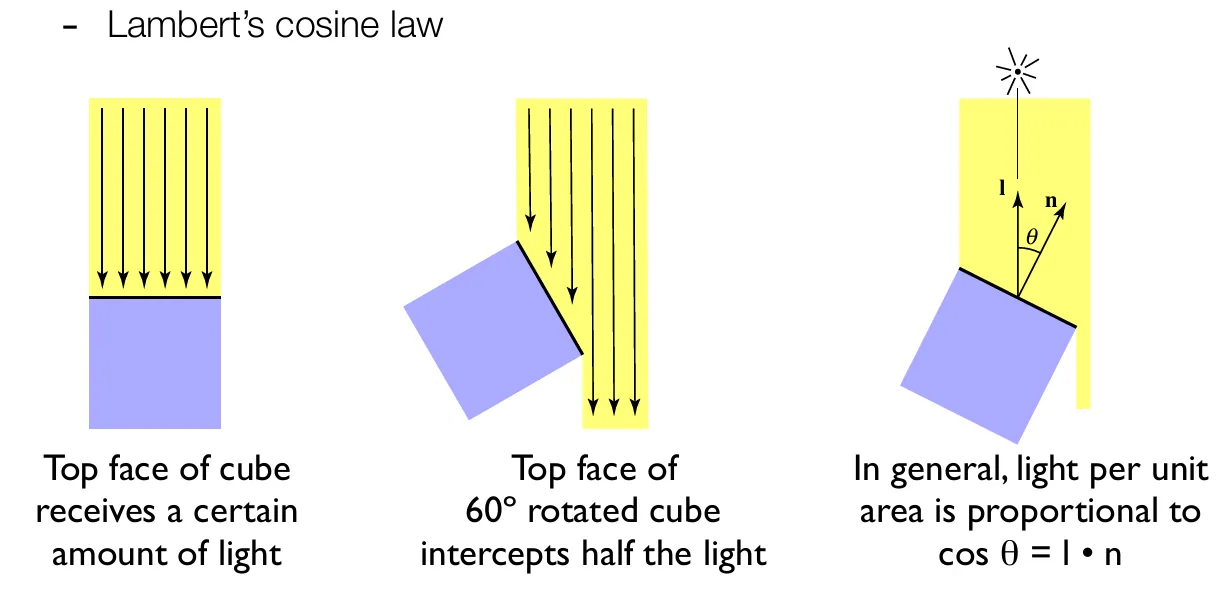
再乘上距离衰减。点光源向外发散,半径 的球面上总能量不变,球面积是 ,单位面积强度按 下降。
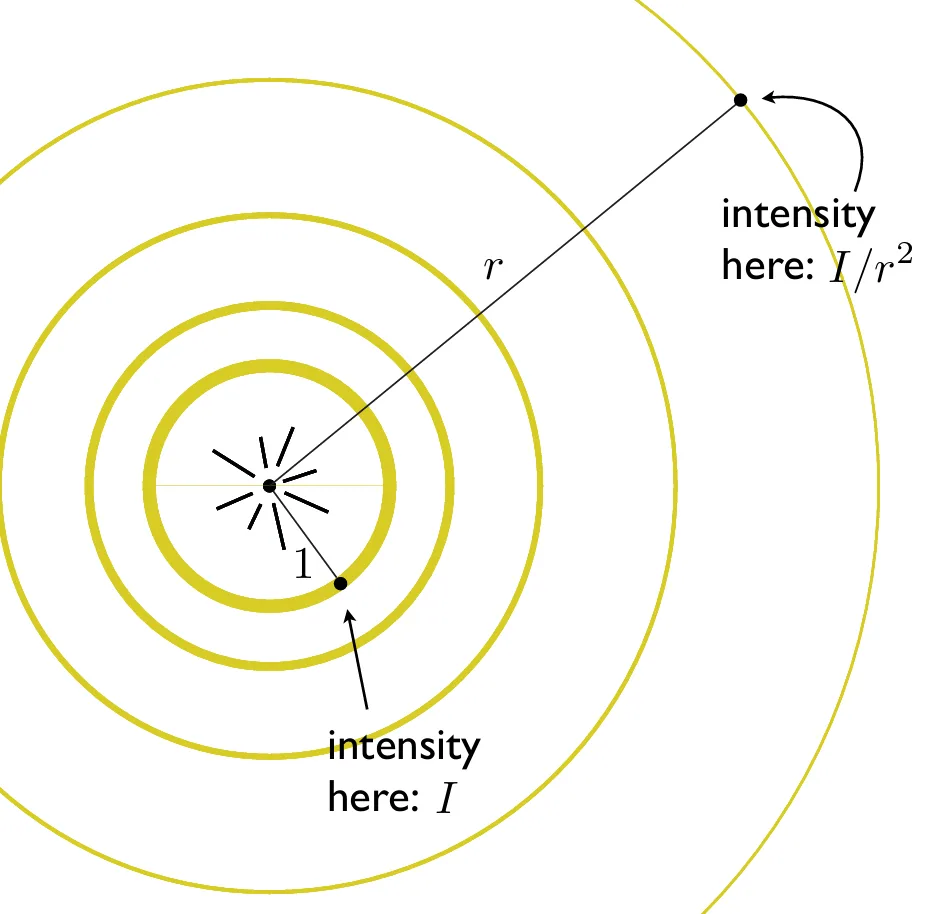
把背向光源的半个球面截成 0。 是漫反射系数,通常直接当作表面颜色;漫反射项与观察方向 无关,转到哪个角度看,亮度都一样。
镜面反射
镜面反射只在观察方向接近反射方向时出现。理想镜面把 关于 对称成 , 与 的夹角越小越亮。
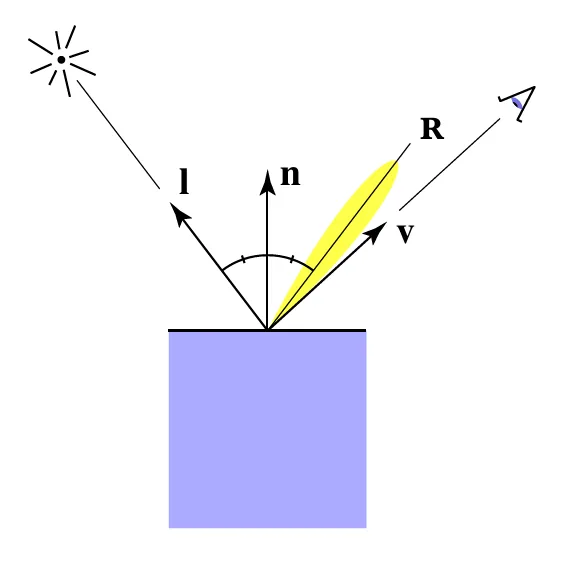
直接用 需要先算反射向量。Blinn-Phong 改看半程向量 与法线 的夹角: 越接近 , 越接近 。
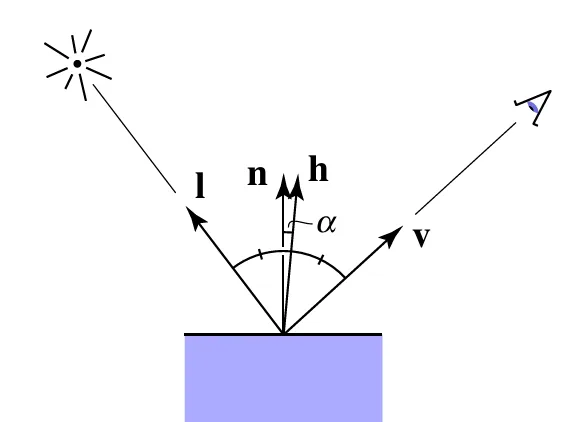
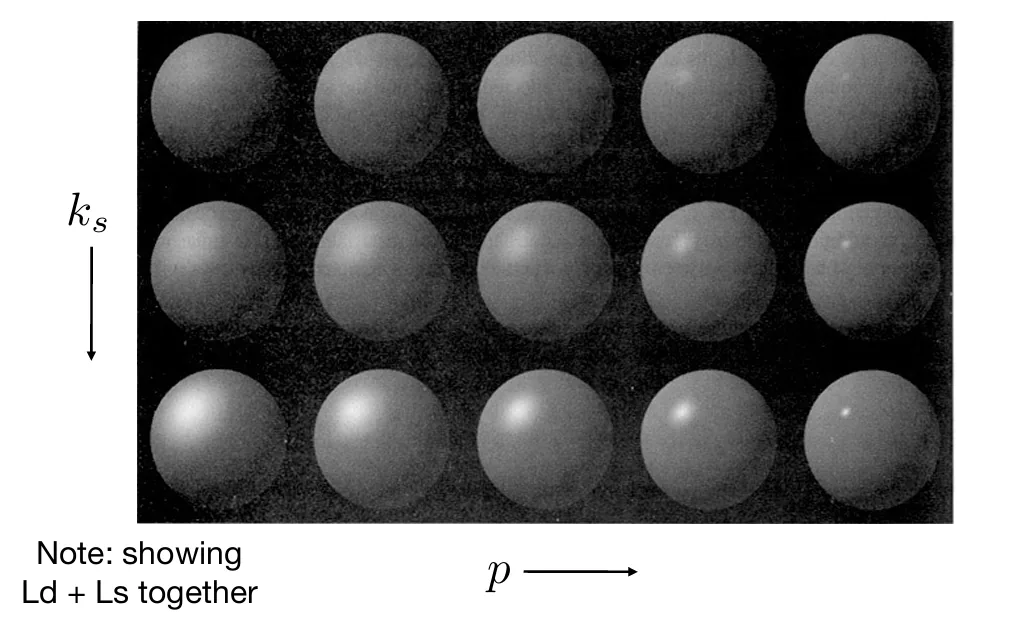
是 shininess。 落在 ,取 次方后小于 1 的值被压小, 越大高光范围越窄、越锐。
三项叠加
逐通道计算,三个系数可以分别是 RGB 颜色, 就是最终颜色。
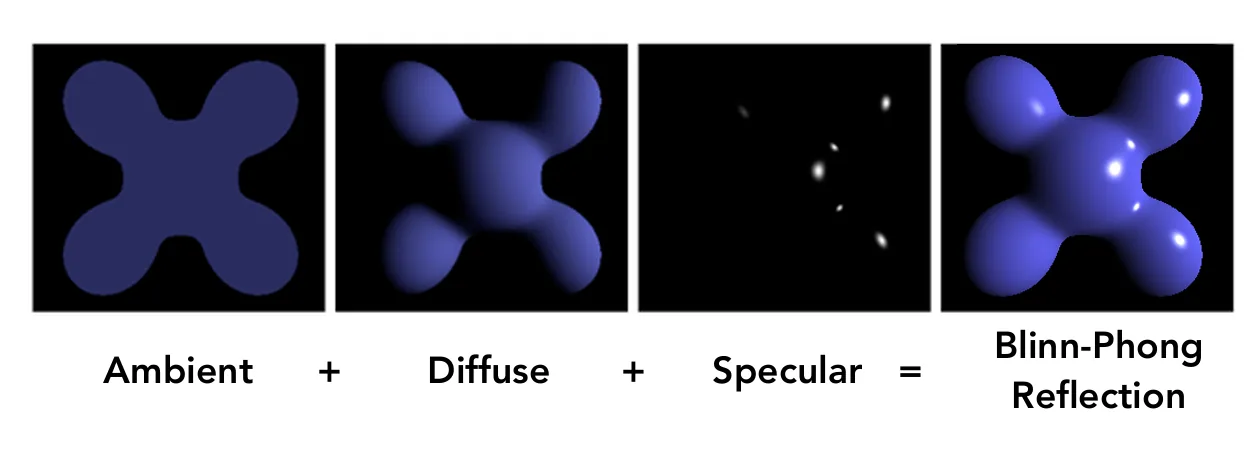
Blinn-Phong 是经验模型,不满足能量守恒, 可以超过 1,也不产生阴影和互反射。它的价值在于便宜、参数直观,适合作为实时渲染的起点。
着色频率
同一套 Blinn-Phong 可以在不同粒度上求值,这叫作着色频率。
- 面着色(flat):每个三角形算法线,整个三角形一个颜色。
- 顶点着色(Gouraud):每个顶点算法线和颜色,三角形内部插值颜色。
- 像素着色(Phong):每个顶点算法线,内部插值法线,再逐像素算光照。
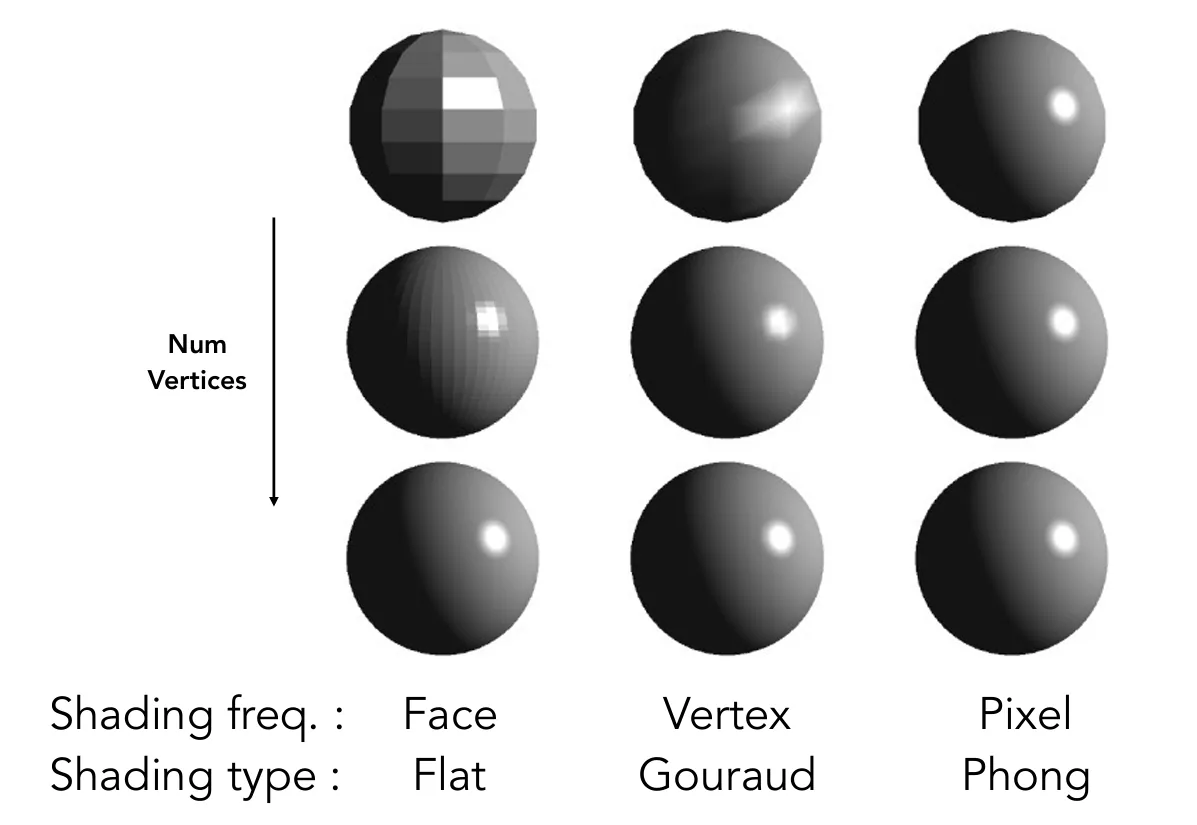
顶点法线通常由相邻面的法线加权平均得到,权重可以用面积或夹角;球、圆柱这类解析曲面可以直接由位置减球心得到法线。频率和反射模型是两件事:Blinn-Phong 是“每个点怎么算”,频率是“算多少个点”。
网格足够密时,Gouraud 和 Phong 的差别很小;高光很锐或网格很粗时,逐像素着色才跟得上。现代 GPU 基本都在片元阶段逐像素着色。这里的 Phong 指着色频率,反射模型用的是 Blinn-Phong,两个 Phong 指的不是同一件事。
渲染管线
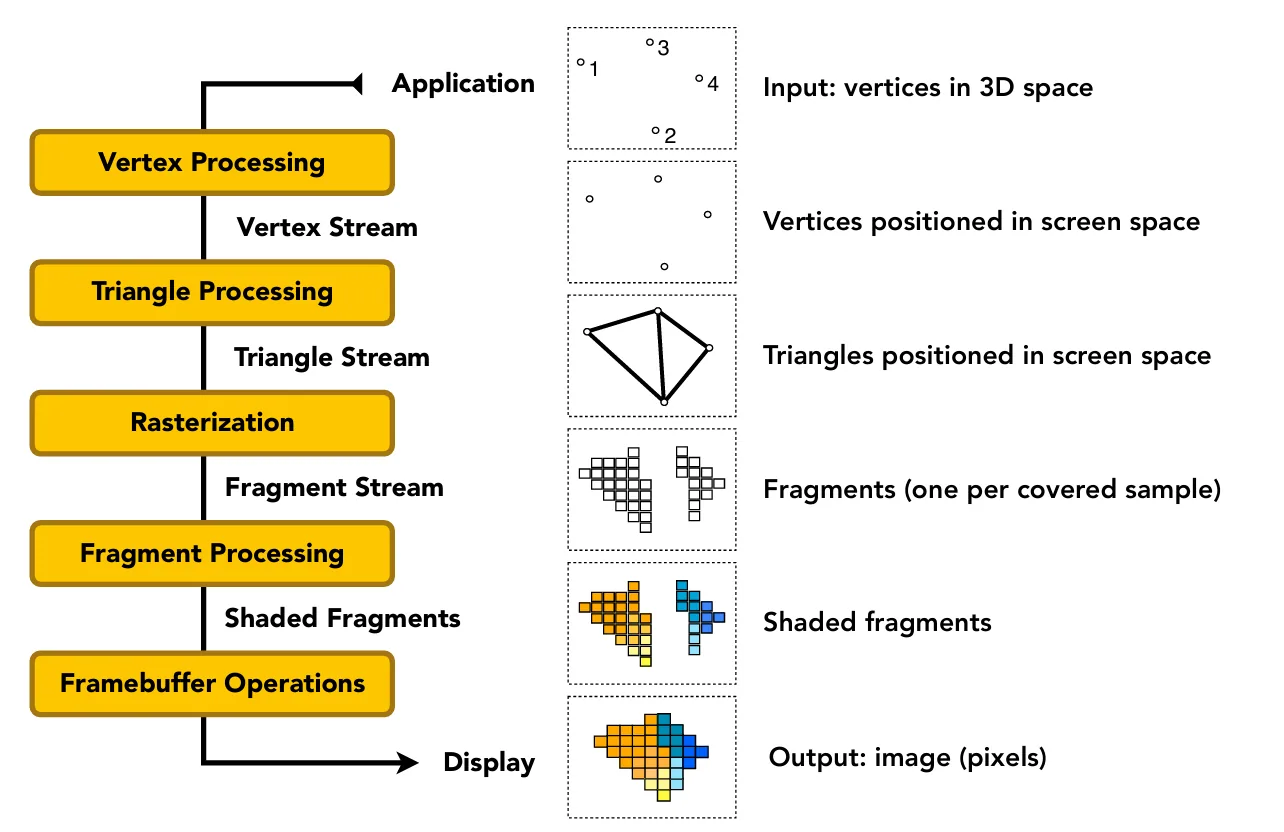
管线把上面的步骤串成固定顺序:
- 顶点处理:做模型、视图、投影变换,把顶点送到屏幕空间。
- 三角形处理:裁剪掉视锥外的部分,组装三角形。
- 光栅化:判断三角形覆盖哪些样本,生成片元。
- 片元处理:逐片元着色、采样纹理、做深度测试。
- 帧缓冲操作:混合并写入颜色。
顶点处理和片元处理可以由 shader 编程,光栅化和帧缓冲操作由硬件固定。纹理采样发生在片元处理,所以它在光栅化之后;这一讲剩下的内容都在第 4 步里。
纹理映射
UV 与 texel
逐顶点指定颜色不够用。真实表面有木纹、砖缝、皮肤细节,用几何去建模这些细节代价太高;纹理是一张二维图像,纹理映射(也常叫材质映射)把表面上的每个点对应到图像上的一个位置,用查表代替建模。
这个对应关系叫参数化。常用做法是给每个顶点一组二维坐标 ,两个方向都归一化到 ,称为 UV;三角形内部每个像素的 UV 由重心坐标插值得到。
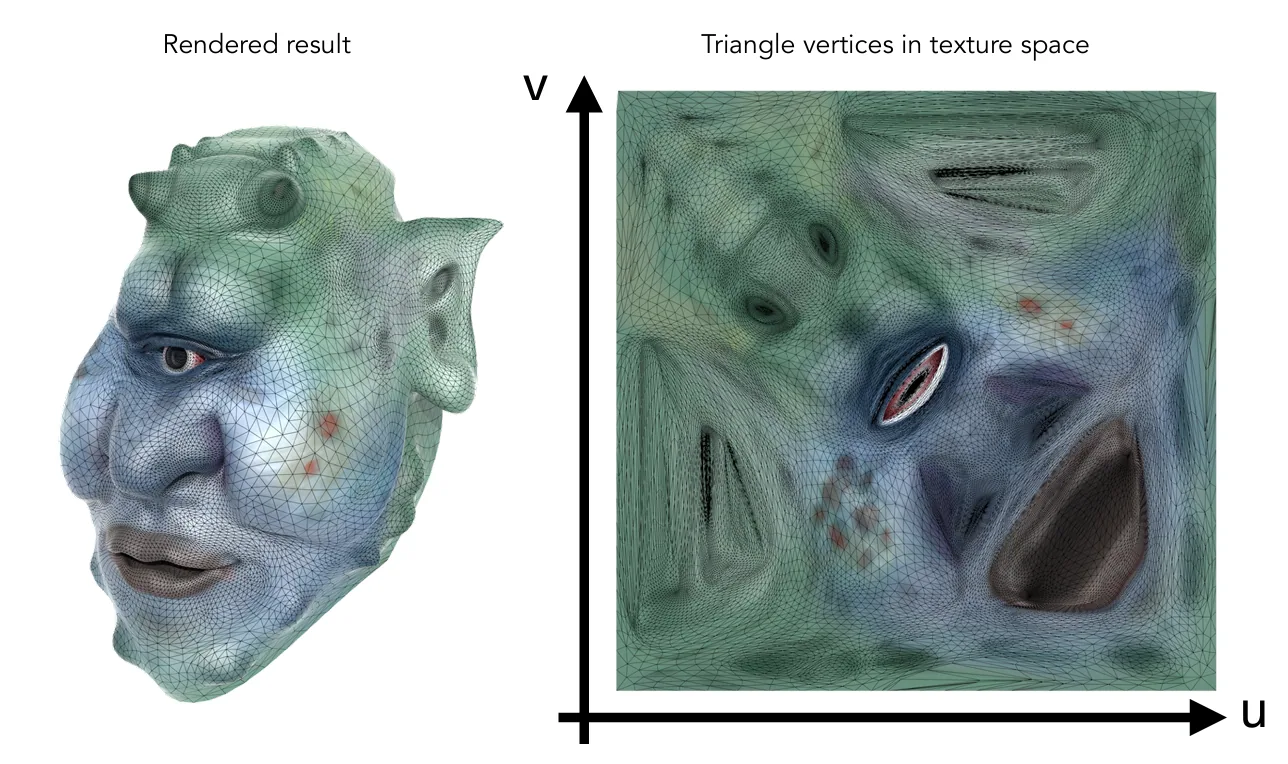
纹理里的像素叫 texel。纹理宽 、高 时,索引 的 texel 覆盖 ,中心在 。
图像文件通常把第一行放在顶部,而 UV 的 轴向上,读取时要做一次 的翻转。上一讲处理屏幕坐标时也遇到过同样的方向问题。
重心坐标与透视校正
三角形内一点用三个顶点表示:
称为重心坐标。几何上, 等于 与 组成的子三角形面积除以总面积, 同理;三个系数都非负时点在三角形内。屏幕空间里可以直接用二维坐标算这三个系数,做法和上一讲的边缘函数一致。
顶点上带着 UV、颜色、法线,三角形内部的值要靠这三个系数插值。直接写 在正交投影下是对的,在透视投影下会偏。
原因在透视除法。屏幕上的 是在投影后的二维三角形上算的,投影把每个顶点除了一个 ,近处除得小、远处除得大,屏幕上的比例和三维空间里的比例不再一致。地面向远处延伸时,纹理坐标在屏幕上被非线性压缩,直接线性插值会让纹理扭曲、向远处游动。
设三个顶点裁剪空间的 为 ,校正后的 记作 :
推导只差一步。三维空间里那个点的重心权重记作 ;同一个点投影到 NDC 后,既等于 ,又等于 ,比较 的系数就得到 ,三个顶点轮换同理。代回 就得到上式。
正好是插值出来的 。透视投影的 与视空间深度成正比,而深度缓冲里的 NDC 是 的单调函数,所以 也能反映该像素的深度。
边界检查:三个 相同时,,公式退化成 ;正交投影的 恒为 1,因此不需要透视校正。
这一步由光栅化硬件完成,shader 里拿到的 UV 已经校正过。双线性插值处理的是后面一步:给定 UV,怎么在四个相邻 texel 之间取值。
放大、缩小与最近邻
一个屏幕像素在纹理空间覆盖的面积可大可小。纹理比像素密时,一个像素覆盖多个 texel,叫缩小;纹理比像素疏时,一个 texel 铺到多个像素上,叫放大。
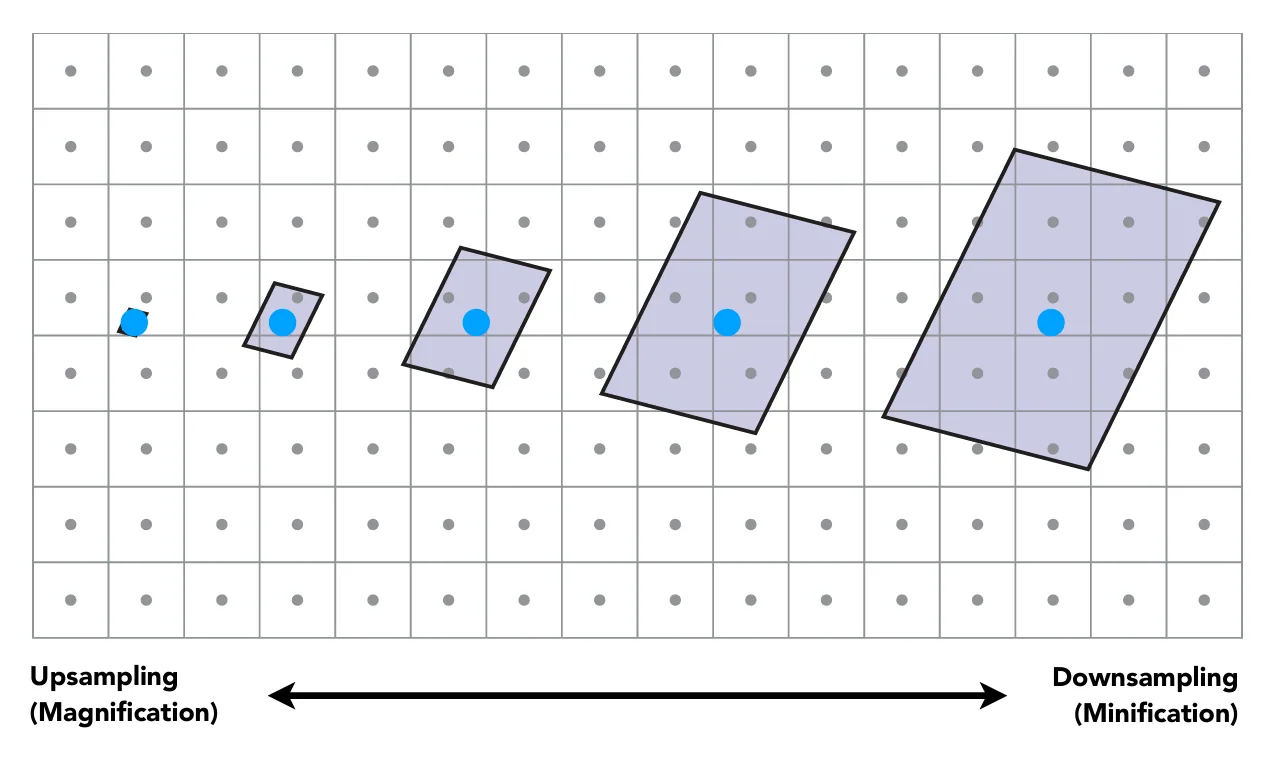
最近邻是最直接的采样:把 UV 落到 texel 网格上,取所在格子的那个 texel。
里的 来自图像行从上到下、UV 从下到上。放大时,一个 texel 被复制成一块方块,边缘是硬的;缩小时,一个像素只取一个 texel,周围的信息被丢掉。
双线性插值
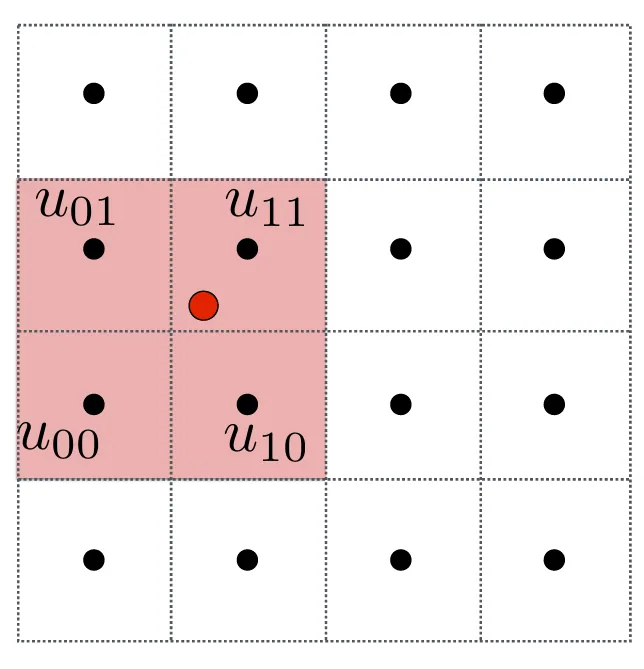
最近邻的问题是结果不连续:UV 稍微跨过 texel 边界,颜色就跳一下,放大后能看到明显的方块。双线性插值用 UV 周围四个 texel 加权平均,让颜色在格子之间连续过渡。
把 UV 换算到 texel 坐标:,。取 ,,小数部分
四个 texel 分别是左下 、右下 、左上 、右上 。先在水平方向插值两次:
再在竖直方向插值一次:
是下边两个 texel 的混合, 是上边两个的混合,最后按 在两者之间过渡。
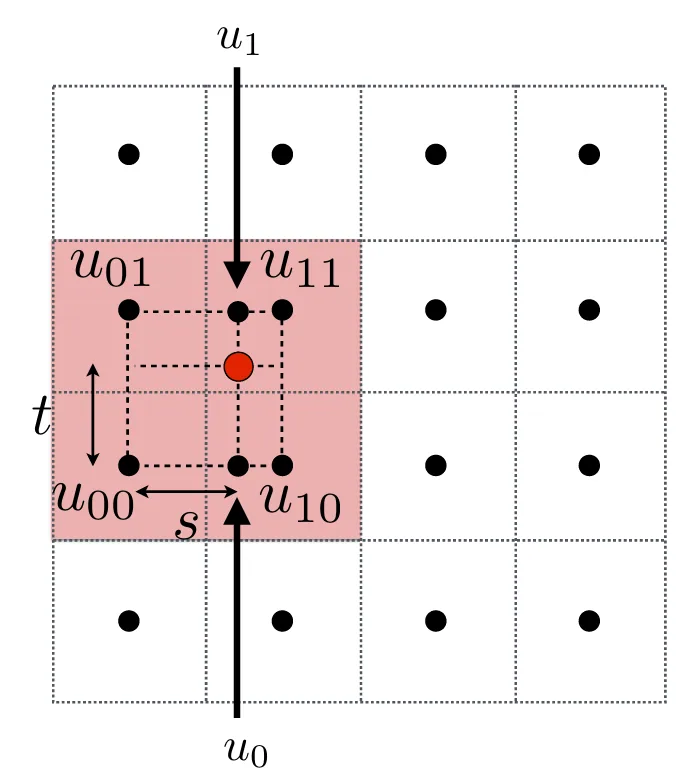
展开后是四个 texel 的加权和:
四个权重都非负,和为 1,所以结果不会超出四个 texel 的取值范围。“双线性”指两次一维线性插值,先沿 插,再沿 插;顺序反过来结果一样。
与最近邻相比,双线性只多三次插值和三次纹理读取,放大后边缘平滑,代价是高频被压低,纹理看起来软一点。
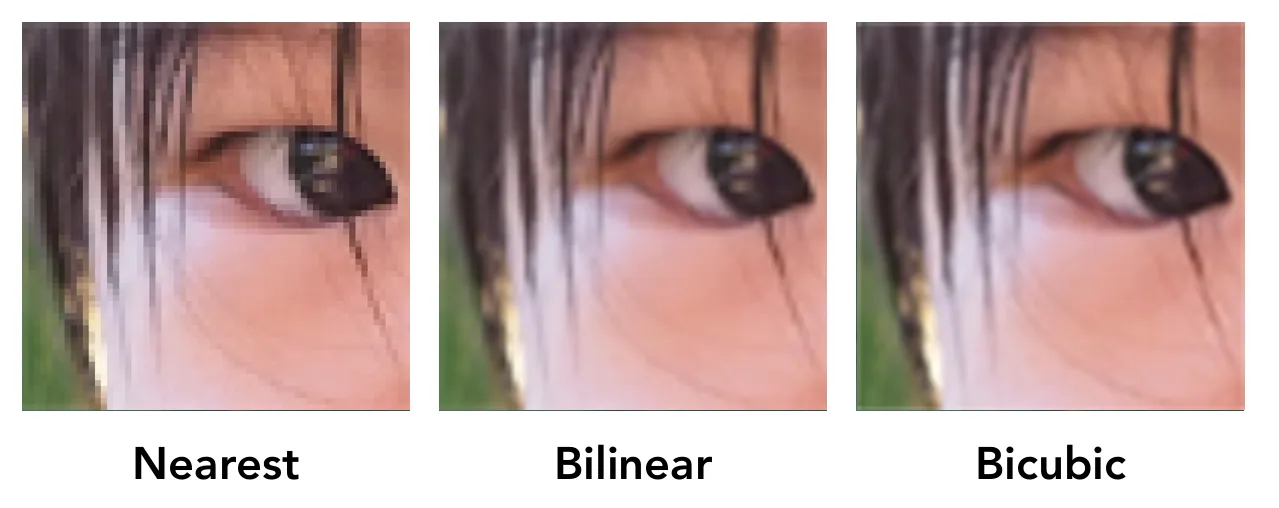
双三次插值用周围 个 texel,权重是三次函数,边缘更锐,代价是 16 次采样。实时渲染里双线性是默认,双三次多用于离线渲染或高质量放大。
边界处理:UV 超出 时,可以 clamp 到边缘、repeat 平铺、mirror 镜像;不同模式只影响越界查询,不改变上面的插值公式。
纹理缩小时的走样
放大时双线性已经够用,缩小时问题不在插值,而在采样率。一个像素覆盖 个 texel 时,点采样只取其中一个,剩下 个被丢掉;纹理越清晰,高频越多,丢掉的信息越明显。结果和上一讲的走样一样:摩尔纹、闪烁,运动时还会抖动。
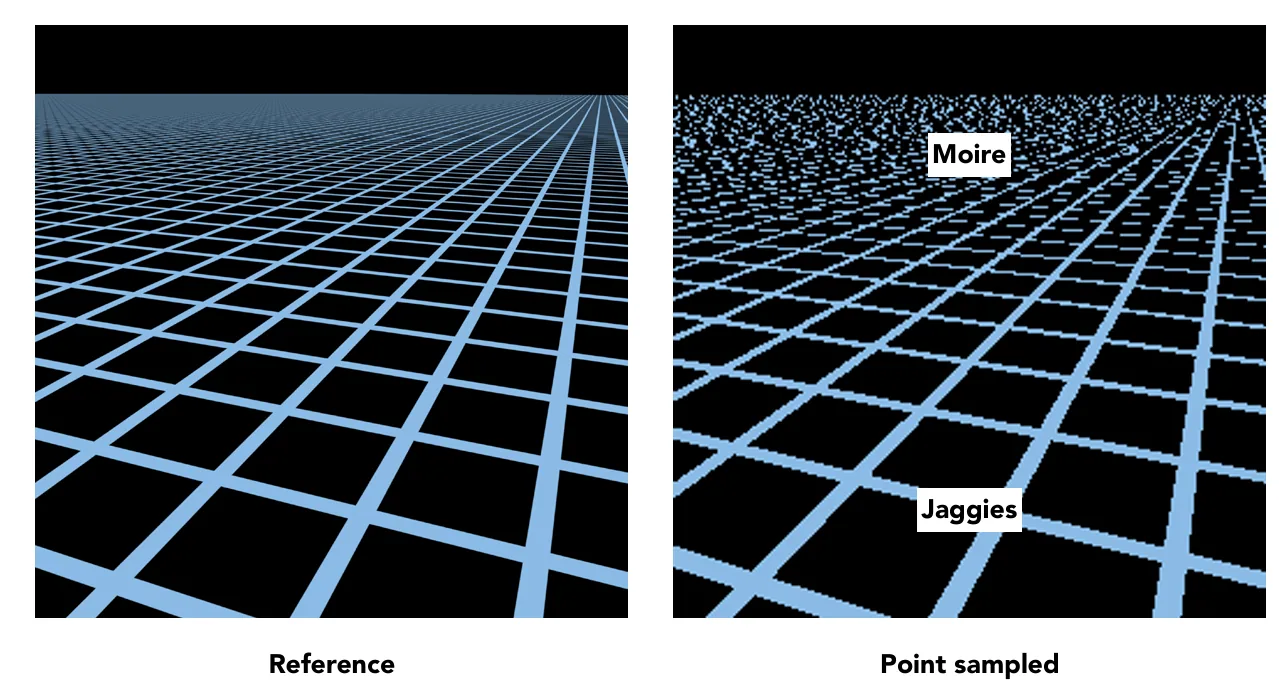
从信号的角度看,屏幕像素是采样点,纹理是连续信号。像素间距固定,采样率就固定;纹理细节超过 Nyquist 频率后,高频折叠进低频。解决思路仍然是先低通再采样:把像素覆盖区域内的 texel 平均成一个值,再参与着色,双线性只看了四个 texel,覆盖不了大面积的缩小。
提高纹理分辨率会让高频更多,走样更严重;提高屏幕分辨率能缓解,但不可能无限提高。
Mipmap
Mipmap 预先算好一系列低通版本,查询时按覆盖面积选一层。第 0 层是原图,第 层边长是原图的 ,每层由上一层 平均得到。
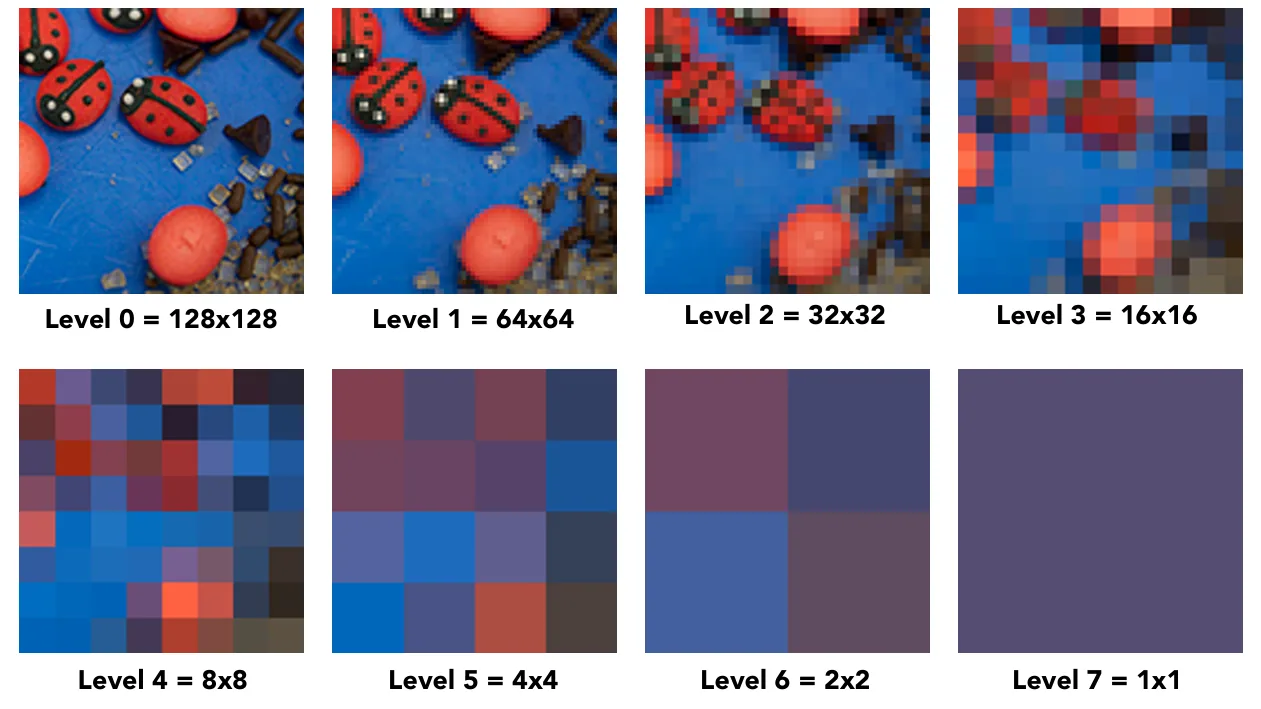
构建一次,查询时直接取;总显存是原图的 倍。
选层
关键是把屏幕像素的覆盖面积换算成层号。把归一化 UV 乘上纹理宽高,得到 texel 坐标,记作 ;沿屏幕 方向走一个像素, 的变化是 ,沿 方向是 。两个方向上的 footprint 长度分别是
取较大的一个:
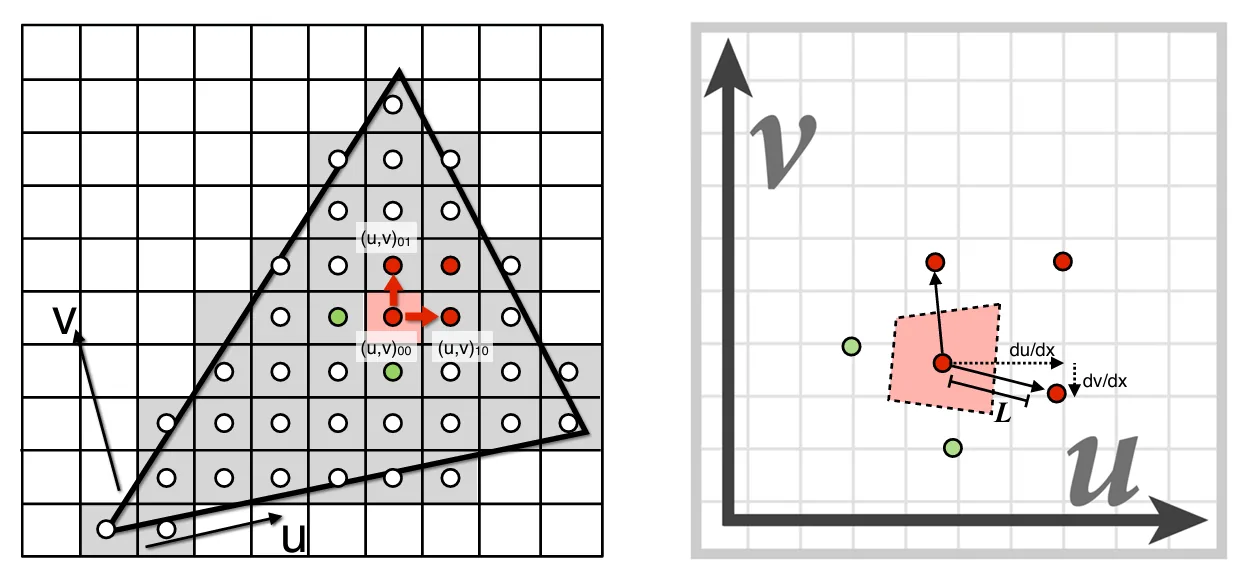
是一个像素在纹理空间覆盖的最大边长,单位是 texel。层号取 ,第 层的 texel 边长正好是 个原 texel,覆盖面积与像素匹配;例如 时 ,用第 2 层,那一层一个 texel 对应原图的 个 texel。
三线性插值
通常不是整数,直接四舍五入会在层与层之间跳变,远处出现一圈圈接缝。三线性插值在相邻两层各做一次双线性,再按 的小数部分在两层结果之间线性插值:
一共两次双线性加一次线性插值。
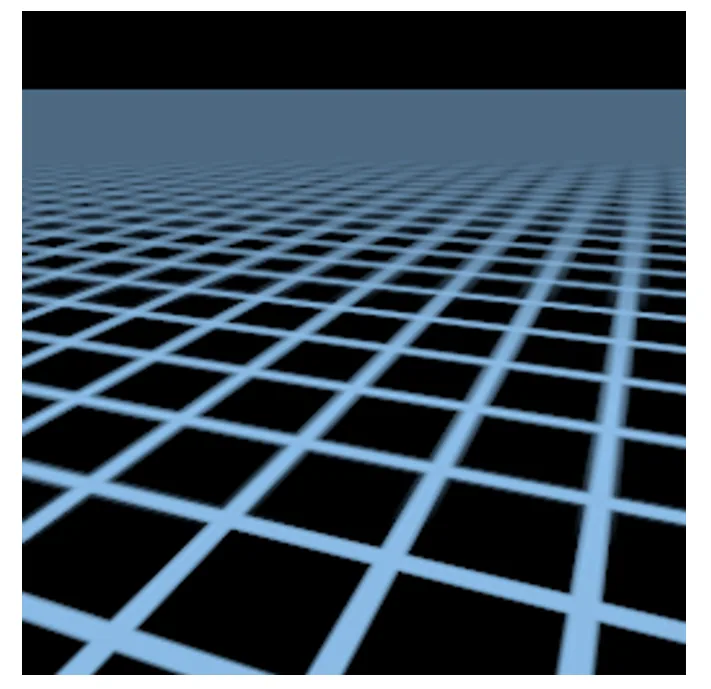
代价是显存多 、每次采样多一次双线性,构建时多一遍降采样;换来的是缩小时基本消除摩尔纹和闪烁。
局限
Mipmap 假设一个像素在纹理空间的 footprint 是正方形,用最大边长 选层就够。斜视时 footprint 是长条:沿一个方向拉得很长,另一个方向几乎没压缩,取最大边长会选到分辨率过低的层,短边方向被过度模糊。
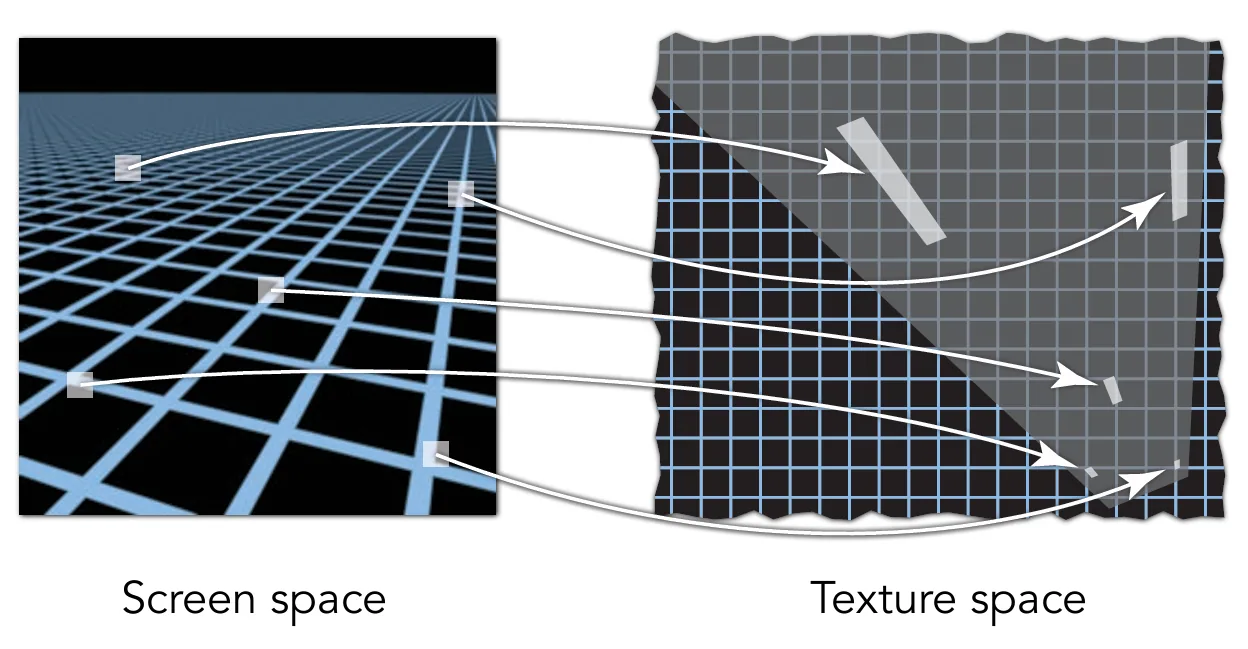
地面向远处延伸时最明显,近处清晰,远处糊成一片。各向异性过滤沿长轴做多次采样,或者存矩形的 mipmap 层(RiPMAP),让两个方向用不同的压缩率,4x、8x、16x 表示沿长轴的采样次数;代价是采样数和显存上升。
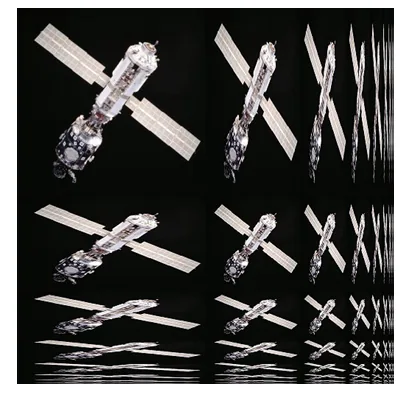
还有 summed-area table 可以查询任意矩形区域,但显存和精度代价更大,实时渲染里不如各向异性过滤常用。Mipmap 解决的是缩小时的频率匹配,各向异性过滤补上方向上的差异,两者都发生在片元处理的纹理采样里。