优化问题
内存别名使用:
void twiddle1(int *x, int *y) {
    *xp += *yp;
    *xp += *yp;
}

void twiddle2(int *xp, int *yp) {
    *xp += 2 * (*yp);
}似乎twiddle1和twiddle2的功能相同,但是当x和y指向同一内存位置时,twiddle1返回4 * (*x),而twiddle2返回3 * (*x)
编译器的原则是优化前后的程序行为必须相同,因此编译器不会选择将twiddle1优化为twiddle2
副作用:
int f(void);

int fun1(void){
    return f() + f();
}

int fun2(void){
    return 2 * f();
}
int cnt = 0;
int f(void) {
return cnt++;
}fun1和fun2由于f具有副作用,因此结果不一致,编译器不会将fun1优化为fun2
代码移动
typedef struct {
    int len;
    data_t *data;
} vec_rec, *vec_ptr;
void combine1(vec_ptr v, data_t *dest)
{
int i;
*dest = IDENT;
for (i = 0; i < vec_length(v); i++)
{
data_t val;
get_vec_element(v, i, &val);
*dest = *dest OP val;
}
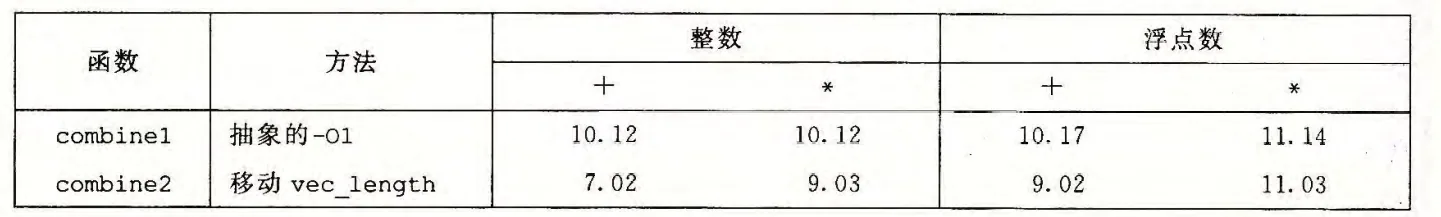
}注意到vec_length(v)是一个常量,但是每一次循环迭代都会调用vec_length(v)函数来获取长度
进行代码移动优化后:
void combine2(vec_ptr v, data_t *dest)
{
    int i;
    int length = vec_length(v); // 将vec_length(v)的结果存储在length变量中
    *dest = IDENT;
    for (i = 0; i < length; i++)
    {
        data_t val;
        get_vec_element(v, i, &val);
        *dest = *dest OP val;
    }
}
减少内存引用
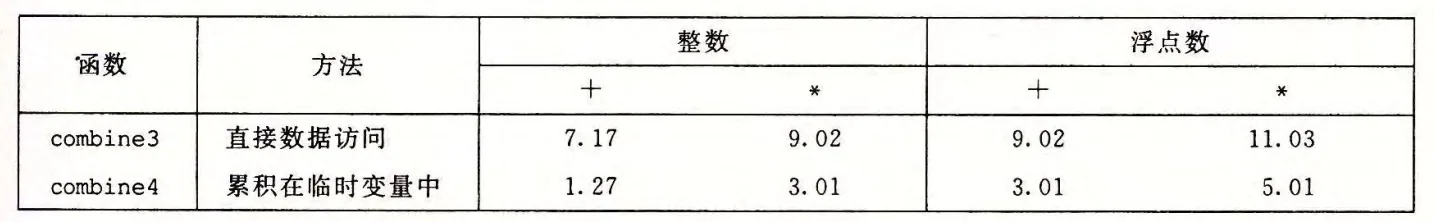
combine2函数中每次迭代都需要访问内存中的*dest,可以通过将*dest的值存储在寄存器中来减少内存引用:
void combine4(vec_ptr v, data_t *dest)
{
    int i;
    int length = vec_length(v);
    data_t result = IDENT; // 将*dest的值存储在result变量中
    for (i = 0; i < length; i++)
    {
        data_t val;
        get_vec_element(v, i, &val);
        result = result OP val; // 使用result变量进行计算
    }
    *dest = result; // 最后将结果写回*dest
}
减少相关性
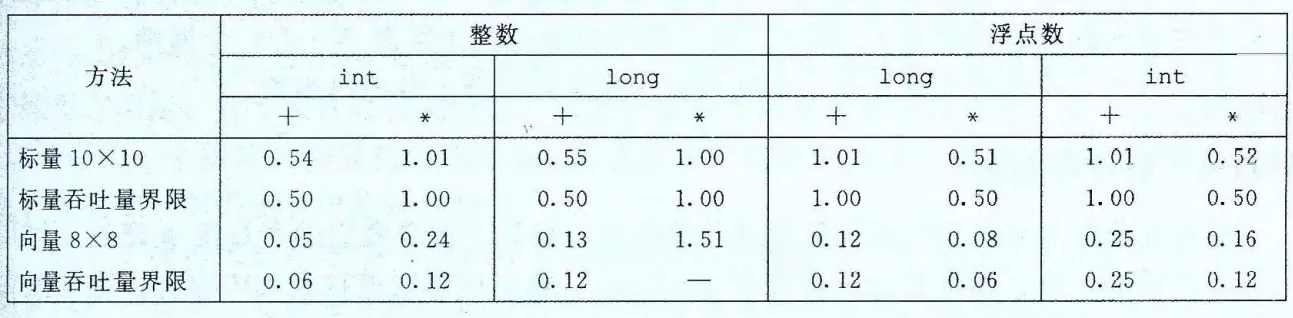
一个CPU的性能可以由延迟、发射和吞吐量来衡量
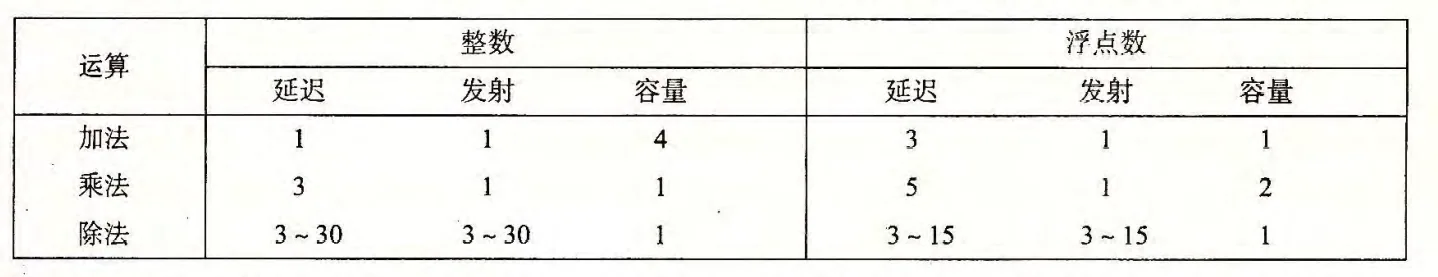
- 延迟(Latency)是指完成一个操作所需的时间,通常以时钟周期为单位
- 发射(Issue)指两个指令之间所需间隔的时钟周期数
- 容量(Throughput)是指一共有多少个单元可以同时执行指令
用CPE表示为
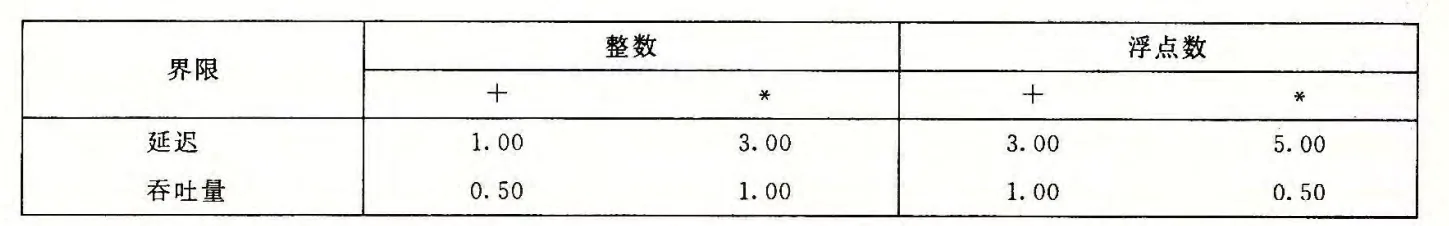
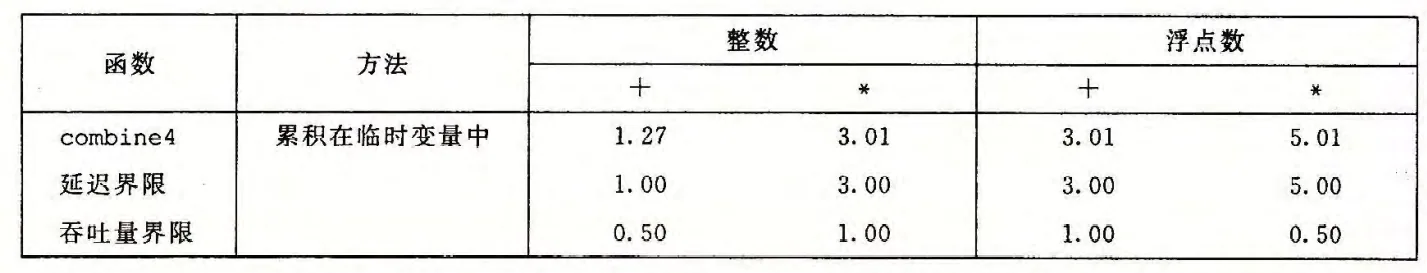
可以看到combine4的CPE无法突破延迟界限,因为每次迭代都依赖于前一次迭代的结果,不能充分利用吞吐量
从汇编角度分析
# Inner loop of combine4.  data_t = double, OP = *
# acc in %xmm0, data+i in %rdx, data+length in %rax

.L25:                                 # loop:
   vmulsd   (%rdx), %xmm0, %xmm0      # Multiply acc by data[i]
   addq     $8, %rdx                  # Increment data+i
   cmpq     %rax, %rdx                # Compare to data+length
   jne      .L25                      # If !=, goto loop
画出关键数据流图:
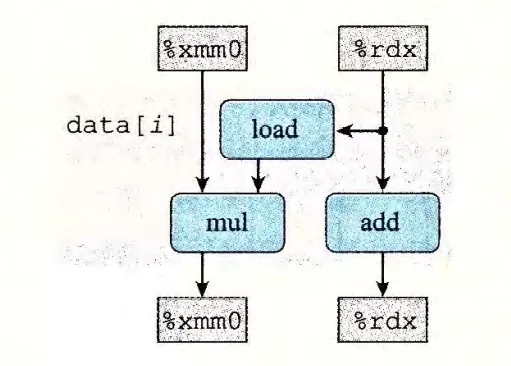
将多次循环放到一起可以得出关键路径
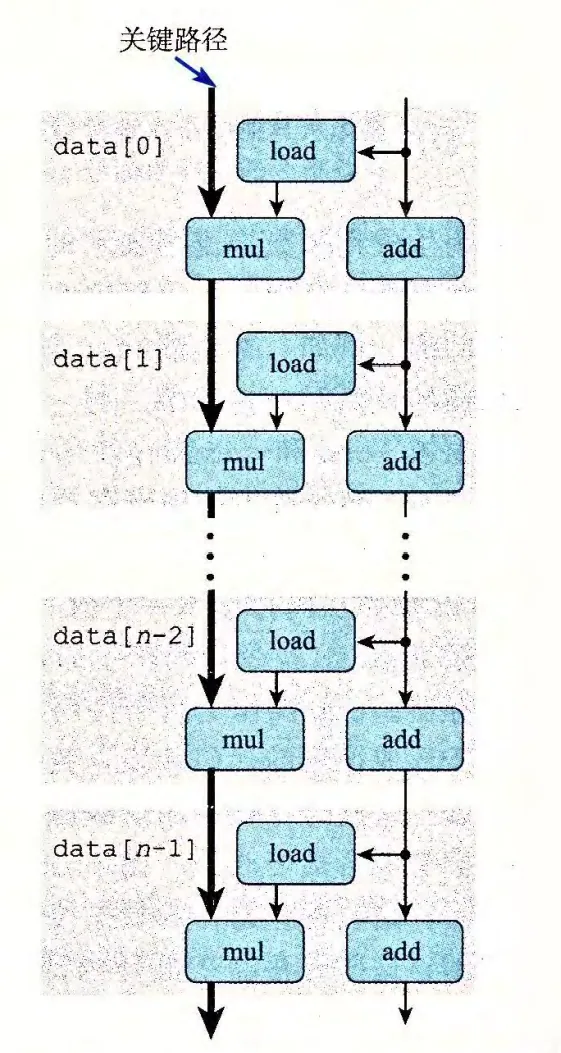
可以看到每次迭代的%xmm0的乘法,也就是result = result OP val的操作是关键路径,无法并行化,因此CPE无法突破延迟界限
循环展开
/* 2 x 1 loop unrolling */
void combine5(vec_ptr v, data_t *dest)
{
    long i;
    long length = vec_length(v);
    long limit = length-1;
    data_t *data = get_vec_start(v);
    data_t acc = IDENT;

    /* Combine 2 elements at a time */
    for (i = 0; i < limit; i+=2) {
        acc = (acc OP data[i]) OP data[i+1];
    }

    /* Finish any remaining elements */
    for (; i < length; i++) {
        acc = acc OP data[i];
    }
    *dest = acc;
}将循环展开,一次执行多步骤,称为循环展开,其中是每次迭代执行的步骤数
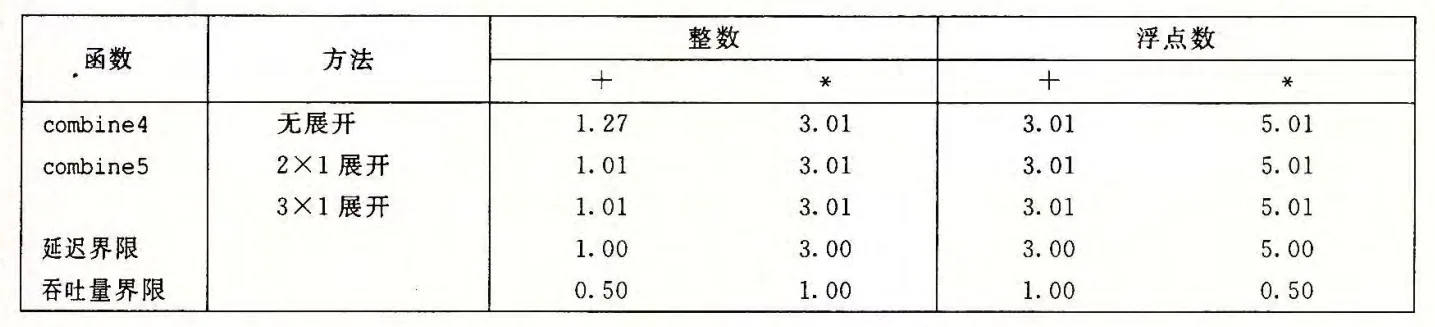
可以看到combine5的CPE仍然无法突破延迟界限,这是由于每次迭代的OP data[i + 1]的操作依赖于acc OP data[i]的结果,仅仅是减少了循环判断次数的性能开销
尝试使用多个累计变量,这样的循环展开称为循环展开,其中是每次迭代执行的步骤数,是使用的累计变量数量
/* 2 x 2 loop unrolling */
void combine6(vec_ptr v, data_t *dest)
{
    long i;
    long length = vec_length(v);
    long limit = length-1;
    data_t *data = get_vec_start(v);
    data_t acc0 = IDENT;
    data_t acc1 = IDENT;

    /* Combine 2 elements at a time */
    for (i = 0; i < limit; i+=2) {
        acc0 = acc0 OP data[i];
        acc1 = acc1 OP data[i+1];
    }

    /* Finish any remaining elements */
    for (; i < length; i++) {
        acc0 = acc0 OP data[i];
    }
    *dest = acc0 OP acc1;
}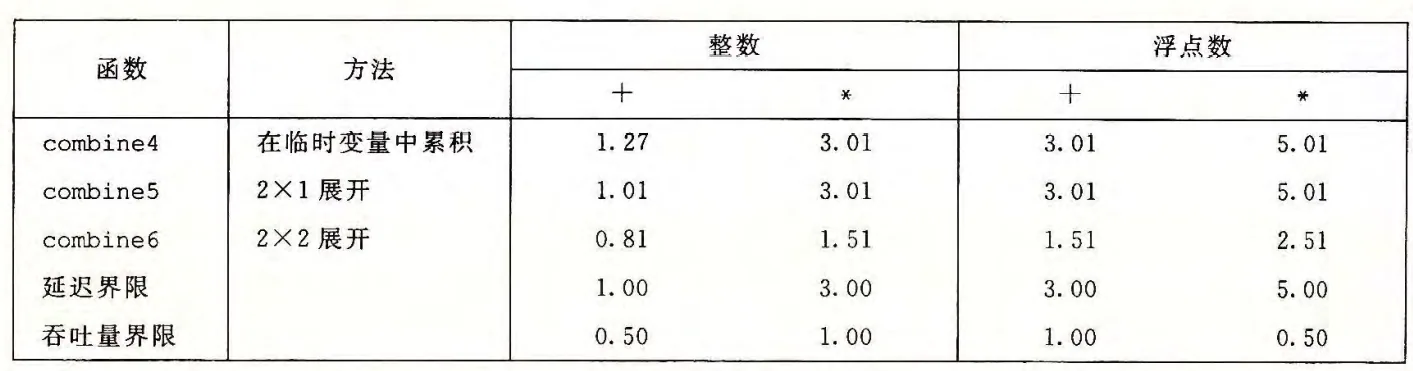
可以看到combine6的CPE突破了延迟界限,因为每次迭代的acc0 OP data[i]和acc1 OP data[i + 1]的操作可以并行执行,不再依赖于前一次迭代的结果
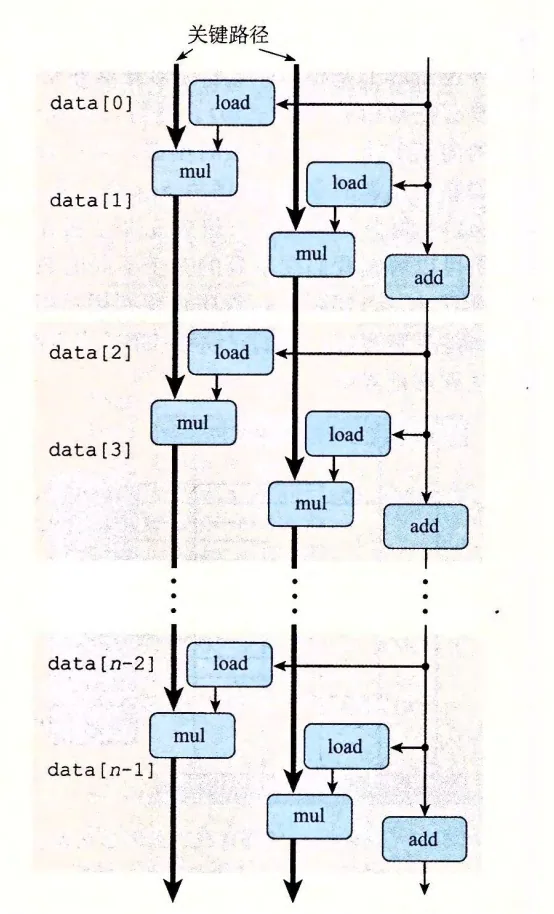
可以观察到combine6的关键路径分为了两条独立的路径
重新结合变换
现在讨论另一种提高combine5性能的方法,重新结合变换
/* 2 x 1a loop unrolling */
void combine7(vec_ptr v, data_t *dest)
{
    long i;
    long length = vec_length(v);
    long limit = length-1;
    data_t *data = get_vec_start(v);
    data_t acc = IDENT;

    /* Combine 2 elements at a time */
    for (i = 0; i < limit; i+=2) {
        acc = acc OP (data[i] OP data[i+1]);
    }

    /* Finish any remaining elements */
    for (; i < length; i++) {
        acc = acc OP data[i];
    }
    *dest = acc;
}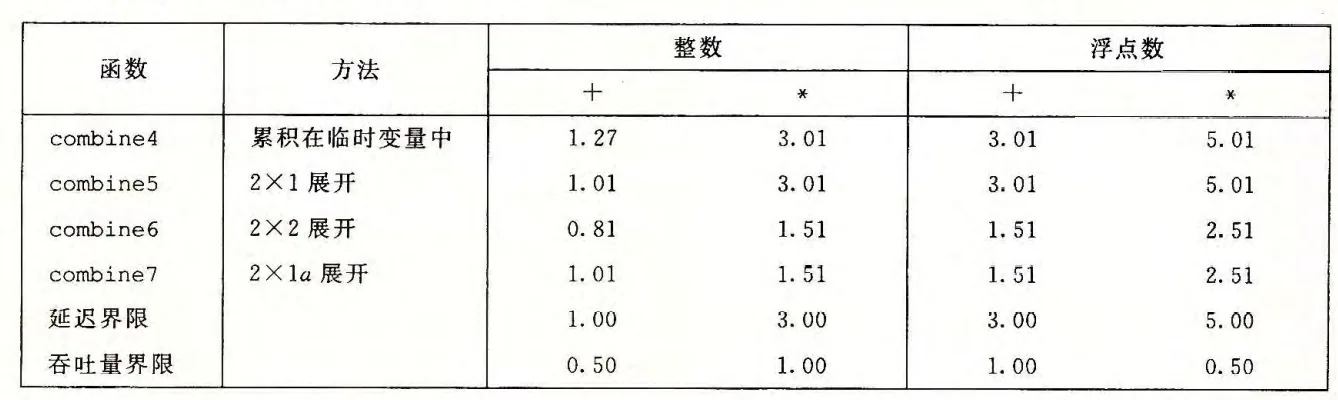
结果是令人吃惊的,浮点数的运算性能提高了两倍
这是因为重新结合变换改变了计算的顺序,使得每次迭代的acc OP (data[i] OP data[i + 1])的操作不再依赖于前一次迭代的结果,可以并行执行
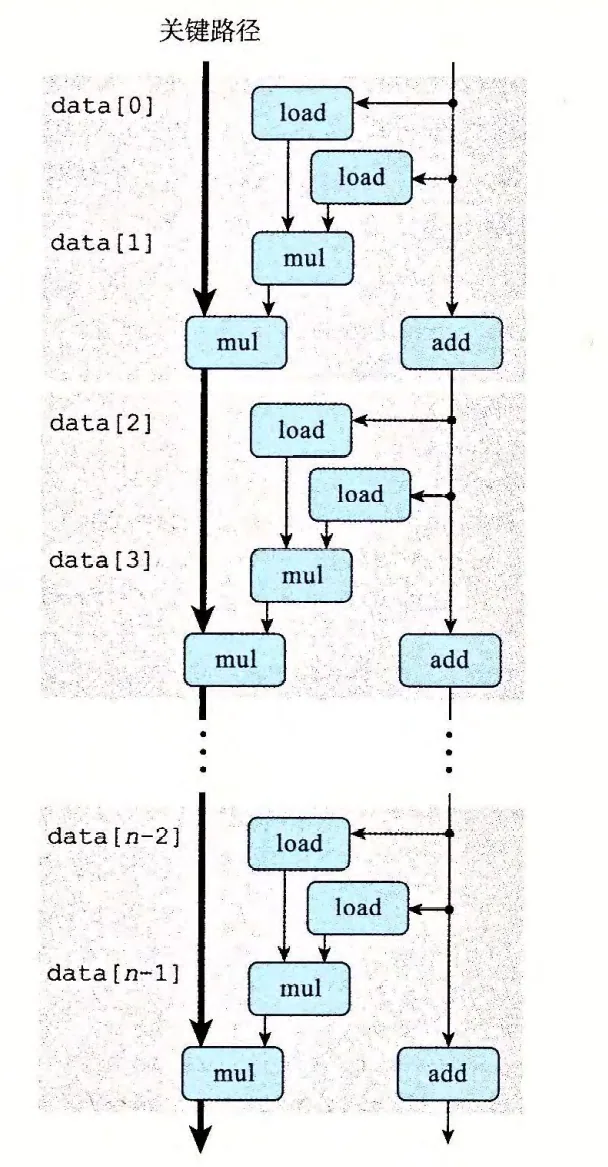
从关键路径可以看出,关键路径上面执行的mul操作减少了一半
使用SIMD并行
使用SIMD(Single Instruction, Multiple Data)指令可以同时对多个数据进行操作,进一步提高性能